Meta Muse
- 1: Meta Muse介绍
- 1.1: Muse介绍: 全球首个面向所有人打造的个人 AI 智能体
- 1.2: [官方文章]我们如何设计 Muse
- 1.3: 从 ChatGPT 到 Muse:AI 正在长出"云端身体"
- 1.4: 什么是 Meta Muse:个人 AI 智能体、定价与 Sentinel 权限模型
- 2: Meta Muse架构
- 3: Meta Muse Connector
- 4: Meta Muse安全
- 4.1: [博客]我们如何将安全构建进 Muse
- 4.2: Muse 智能体位于内核级 Sentinel 之后
- 5: Meta Muse分析
1 - Meta Muse介绍
1.1 - Muse介绍: 全球首个面向所有人打造的个人 AI 智能体
来源:Introducing Muse: The World’s First Personal AI Agent Built for Everyone
日期:2026 年 9 月 8 日
更新:2026 年 9 月 30 日
页首有一段介绍视频。
要点
-
Muse 是个人 AI 智能体。它实际完成工作,而不停留在回答问题。它帮助人们掌握各项事务的进展,承接任务与项目,并把长期目标转化为行动计划。
-
Meta 从零构建 Muse,使其成为一个注重隐私、使用上安全、具备防护,并且可以广泛提供的个人 AI 智能体。
-
Muse 运行在 Muse Secure VM 上。这是一台配有自己的浏览器的专用安全计算机。Muse 可以代表用户,在其日常使用的各个应用之间工作;它从对话中学习,反思对用户重要的事情,并在此过程中变得更精准。
-
每个人都保持对自己的 Muse 的控制,并决定授予它多少访问权限。
-
若要进一步了解 Muse 如何设计,以及安全、防护与隐私如何被构建进去,可读 How We Built Safety Into Muse 与 How We Designed Muse。
今天,Meta 发布 Muse。这是一个具备防护、注重隐私的个人 AI 智能体,它主动协助人们推进目标,并提出想法。个人智能体需要一种新的安全计算机,因此 Muse 运行在 Muse Secure VM 上。这是一台专用虚拟机(VM),同时容纳智能体与个人的数据。Muse 围绕人们既有的沟通方式设计,与它交谈如同给另一个人发消息,可以在 Muse 应用中进行,也可以直接在 WhatsApp 中进行。
用法简单。人们告诉 Muse 需要完成什么,它便采取行动。驱动它的是 Muse Spark,即 Meta 迄今能力最强的模型,为这类真实环境中的智能体工作而构建。
工作方式
与其他智能体不同,Muse 的构建目标是服务全球数十亿人,因此不需要专门学习。任何人都可以直接开始使用,不需要技术经验。它可以处理发送电子邮件、预订行程这类任务,也可以承接宏大的目标。一旦有人把目标告诉 Muse,它会帮助制定个性化计划,协调时间与资源,然后自行推进这项工作。它可以打开浏览器、填写表单,并代表用户进行协商。
对于耗时更长的任务,人们关闭应用之后,Muse 仍继续工作;当事情发生变化,或它需要批准时,它会回来。需要批准的情形包括发送电子邮件之前,以及完成购买之前。它以更少的投入得到更好的结果,例如以更高的价格卖出汽车、压低一笔账单,或在生活的其余部分发生变化时调整训练计划。
到需要付款时,Muse 可以使用 Stripe 推出的 Link 结账。它是首个被纳入 Link 购买保障 的 AI 智能体。对符合条件的购买,保障包括物品损坏或丢失时的免费赔付、降价保障、免手续费退货,以及退货保证。Link 面向智能体的钱包会生成一次性卡,真实卡信息保持隐藏,从而可以在互联网上安全地完成购买。Shop Pay 即将作为另一种支付方式推出;同时将支持 1Password,使 Muse 可以使用用户已经保有的登录信息。
Muse 也会记住对一个人重要的事情,因此可以主动提出建议,并依据此人只提到过一次的细节采取行动。它可以把此人在 Instagram 上保存的菜谱 Reel 转成购物清单,为晚宴建议菜单,并在发出邀请之前记住朋友的饮食限制。
原文在此处嵌入三段演示视频。
为隐私、安全与防护而构建
个人智能体需要一种新的安全计算机,因此 Meta 为所有人构建了一台。Muse Secure VM 内建了隐私、安全与防护;原文将这些防护称为同类中的首创,并且是其他智能体所没有的:
-
Muse 在云端自己的专用计算机上运行,并加以隔离,使其他人的智能体无法访问它。Muse 驻留于此;用户所连接的任何服务的数据与凭证,也安全地存储于此。
-
一个独立的 Sentinel 智能体运行在同一台机器上,在系统层面与 Muse 分开。只有在 Sentinel 批准之后,Muse 的操作才会到达互联网;需要时,它会向用户请求许可。
-
Muse 看不到人们的密码或支付方式。用户分享给 Muse 的任何凭证都进入安全存储,因此 Muse 可以使用这些凭证,但看不到它们。用户自己在浏览器中输入的密码,Muse 也看不到。
-
在发送电子邮件或完成购买这类敏感动作之前,Muse 会先与用户确认。Muse 向用户展示完整的审计记录,包括它已经完成的事项,以及计划完成的事项。
-
用户选择 Muse 连接哪些应用,以及确切授予多少访问权限。以电子邮件为例,用户选择 Muse 可以做什么:只读取邮件,或者也可以代表用户发送。
-
用户可以随时更改访问权限,或断开某项服务。用户也可以退出,不让自己的交互被用于训练 Meta 的 AI 模型。
-
Muse 不会把个人的对话,或 VM 中的数据,提供给 Meta 的广告系统。
-
Muse 记住对用户重要的事情;用户随时可以要求它「忘掉」已经学到的特定内容。
原文在此处嵌入一段购物演示视频。
今年晚些时候,Meta 将推出 Muse Confidential VM(机密虚拟机)。整台 VM,包括个人的数据以及与 Muse 的对话,都使用只有用户本人持有的密钥加密,因此 Meta 也无法访问。
展望
Meta 认为,个人超级智能将是一个人一生中最具变革性的技术之一。Muse 是第一步:由智能体承担更多工作,使人们可以把注意力放在对自己重要的事情上。
Muse 正在美国的 iOS、Android 和 muse.ai 上推出,并即将支持 AI 眼镜。对人们所需的大部分用途免费;希望做更多事情的人可以使用订阅方案。
1.2 - [官方文章]我们如何设计 Muse
来源:How We Designed Muse
作者:Mona Sarantakos,与 Christine Awad
日期:2026 年 9 月
页首有一段视频,标注为 “Muse organizing everyday life”(Muse 整理日常生活)。
Christine 和我一起做产品已经将近十年。把我们连在一起的,是对两件事的绝对投入:我们所爱的人,以及我们所构建的产品。平衡这两项优先事项并不容易。这些年里,随着孩子和父母进入新的阶段,我们谈得最多的,是如何不致被事务淹没,以及如何从有限的小时里再多争取一点时间。
对我们来说,Muse 归还了我们最稀缺的资源:与所爱之人相处的时间。
Muse 是我们一起构建过的最个人、也最具挑战的产品。这像是在为一个新时代做设计:模型会主动行动,持有多得多的上下文,并且能力强到可以生成它自己的体验。这意味着大量前所未有的产品决策,包括设想新的沟通方式、创造事物的方式,以及保障数据与动作安全的方式。
以下是一个起点:我们作出的决策,以及我们划下的界线。我们也建议阅读同事 Tarek Sheasha 的博文。那篇文章更深入地说明产品在技术上如何构建,以及用于保护用户及其数据的系统。
我们期待你们亲自体验,并告诉我们你们的看法。
Muse 是一个真正能办事的智能体
Muse 最突出的地方,是看着它真正为你办成一件事。
我们希望 Muse 在完成任务与目标时尽可能有帮助。事实上,我们的系统提示第一行是:
你的目的,是让你的用户生活得更好。
对我来说,让生活变得更好,意味着终于处理完我记在脑子里的待办清单。那份清单让我夜间无法安睡,而且似乎从不变短。
Muse 以我做不到的方式完成这些事。它同时处理多项任务,不会疲倦,也不会分心。这是它唯一的工作。
就在本周,我正在为这次发布做准备时,我让 Muse 管理孩子们的开学准备:盯着大量学校邮件和学区网站,把关键日期放到家庭日历上,把他们需要的用品放进购物车,甚至找到我儿子想要的那件运动衫,而且当时正在打折,并预订一顿晚餐来庆祝返校的第一天。
正是这样,它抓住了我肯定会错过的那件事:埋在那些邮件里的,是我儿子的体育队选拔,十二小时后截止。我的 Muse 在我登机前发来消息,于是我打电话给丈夫,他在还剩四小时时提交了表格。如果没有这次捕捉,我儿子就无法参加选拔。
要完成这一切,Muse 必须极具能力,并且主动。
Muse 有自己的计算机,带有文件系统和终端,因此它可以编写自己的代码,并构建一项任务所需的工具。它还可以使用完整的 Web 浏览器,从而能够搜索、浏览网站、填写表单并完成交易,例如预订和购买。
Muse 也可以为你产出结果,包括文档、PDF、网页等。它可以构建支出跟踪器、交互式学习指南,或一个用来发现睡眠规律的仪表板。
原文此处有图:Muse 创建的富内容 Artifacts 示例。
而且 Muse 一直在工作。一旦设定了目标或任务,Muse 就会按日程继续工作,并响应相关事件,迈出下一步并跟进;与此同时,它也处理你在对话中提出的请求。后台工作完成之后,它会评估结果是否值得呈现,只在出现有实质意义的新情况,或需要你输入时,才通知你。
从助手演进为智能体
设计这个产品时,我们把主对话做成一场长对话,就像与另一个人交谈那样。与其他 AI 应用不同,Muse 不是一轮一答的体验。你可以打断它,也可以一次发送多项任务,而不必等待它回应上一项。它的记忆在各次对话之间保持,并且能够管理大量上下文。在早期测试中,有些人仍然希望某些主题有单独的上下文;随着项目变得更复杂,这是合理的。因此我们构建了侧边对话(side chats)。
Muse 也是主动的。它可以在没有提示时向你发送消息。这意味着发送一条消息的门槛必须很高:主动消息必须真正有帮助,并且值得这次打断。我们认为默认设置对大多数人是合适的;你随时可以让 Muse 关闭主动消息,或把主动程度调低、调高。主动性还迫使我们作出一个较小的决定。一旦消息可以不按轮次到达,而用户又会连续发送好几条,一份平坦、没有边界的记录就不再可读。因此 Muse 使用对话气泡:它们标出一条想法在何处结束,下一条从何处开始。
为 Muse 设计头像和个性,既令人愉快,也是最自然的选择。在这些长时间对话中,对着一个公司标志或一个机构说话,显得很不自然。我们每个人想象中的交谈对象都很不一样。团队里的每个人都开始创建自己的 Muse。我们随之意识到,让它真正属于用户,对这个产品至关重要。创建自己的头像、为它命名,并赋予它独特的风格,已经成为人们反应最强烈的核心功能之一。这就说到我的 Muse:Veda,一个令人联想到智慧的梵语名字。
原文此处有图。图注为 “Veda”;图像说明为 “Veda, Mona’s Muse avatar”(Veda,Mona 的 Muse 头像)。
用 Muse 完成事务
后台工作与透明
Muse 可以管理多项任务,并在应用关闭后于后台进行。这种能力很强,但我们也随之追问:它究竟在做什么?看不见的事情无法信任,因此我们把越来越多的透明做进界面。例如,在头像下方,你会看到它正在处理的内容的一段摘要。点按 Muse 头像,会显示完整的活动日志,以及你已经批准的权限。权限界面、设置,以及记忆文件中也内建了透明;记忆文件可以直接阅读和编辑。
原文此处有图:Muse 的状态与活动视图。
目标与跟踪
我们开始让智能体承担多项长期任务,这些任务往往与我们想达成的目标有关。事实上,Muse 相当擅长拆解目标,并给出可执行的计划。因此,我们需要的不只是一个活动标签页。我们需要一个清楚的视图,看到 Muse 正在为我们跟踪的一切,以及它打算如何到达那里。Goals 标签页是 Muse 为你跟踪这些内容的地方。你可以在那里直接交互,也可以在对话中与它谈论这些任务。
原文此处有图:Muse 的目标与进展视图。
确定性控制
Muse 可以用对话处理很多事情,但在少数领域,对话并不够。因此我们有意划定了确定性界面不可让步的位置:结构清楚的审批卡片,带有明确的接受与拒绝动作,以及用于凭证的安全存储。
原文此处有图:Muse 的结账审批控件。
浏览网页是我们最看重的 Muse 能力之一,但这也带来很大的责任。人在环路功能会在关键动作上与你确认,例如撰写电子邮件或完成购买。我们也不希望出现横幅盲视,也就是人们为了让提示消失而一律批准。监督那些难以撤销的动作很重要。因此默认允许常规的网页浏览,并在难以撤销的事项上停下来。我们也内建了控制,让你把这些默认设置改得更谨慎,或更宽松。
Artifacts
有时,一块文本并不是答案的合适形态。如果请一个人规划旅行,你不会想要一篇两千字的回复,而会想要一份行程。如果在跟踪一段时间内的支出,你可能想要一个实时仪表板,而不是每天一条消息。Muse 可以创建丰富的交互式输出。这些输出通过对话发送,也可以存在于对话之外。我们称之为 Artifacts。我们认为,人们会越来越想要更丰富的、按具体需求定制的界面,而不是今天对话以文本交付的内容。
找到关键之处
早期测试暴露了一个出乎意料的问题:Muse 能做的事情太多,以至于人们不知道从哪里开始。因此我们把 Muse 设计成始终思考它能为你做什么,并根据你的目标、你的行为模式,以及它在对话中学到的内容来生成想法。
Muse 为你创建的想法有多种形式:在最初几天的上手过程中作为提示;在 Ideas 标签页中作为建议;如果 Muse 了解你的目标,它会基于自己的观察以及与你的对话,主动分享新的想法,或对计划的调整。
原文此处有图:Muse 建议的想法。
请看产品设计负责人 Alex 更详细地演示 Muse。
此后的方向
我们看重已经建成的成果,同时也知道现在还早。使用 Muse 时需要审慎,因此请花时间熟悉设置与控制。我们将继续向使用者学习,并迭代产品,使它更有帮助,也更安全。我们将以同等的抱负与审慎来构建,因为二者缺一不可。我们打算以此方式与前沿一同前进。
基于这一点,我们希望你从这个起点开始使用,并期待听到你们自己的 Muse 故事。
1.3 - 从 ChatGPT 到 Muse:AI 正在长出"云端身体"
来源:从 ChatGPT 到 Muse:AI 正在长出"云端身体"
作者:亨利笔记
日期:2026 年 10 月 8 日
从模型竞赛到个人智能体,下一代 AI 正在争夺任务入口
九月份,AI 行业出现了两种类型的产品发布。
一种是模型:Anthropic 的 Claude Opus 5.5,OpenAI 的 GPT-6.1 Sol,谷歌的 Gemini 4 Argon。超强的参数、推理能力、Benchmark,关注的仍然是 AI 的"大脑能力"。

另一种是智能体:Meta 的 Muse,Manus 的 Cue,以及 OpenAI 的 Dots。它们比拼的已经不是"回答得多好",而是"能不能替你把事办完"。
还有消息称,国内大厂也在快马加鞭地研发 Muse 对标的个人智能体差评。
这些产品的发布都挤到同一个月之内,绝对不是巧合。可以说,巨头们在同一时间集体转向个人智能体,这是为什么呢?
答案的线索在模型之外。AI 要真正干活,不能只有大脑,还需要一副身体。过去 AI 的入口是"回答",未来 AI 的入口,可能是"任务"。
从聊天机器人到智能体:AI 从工具变成执行者
聊天机器人是"你问它答",一次交互就结束,没有长期目标:
用户→问题→模型→回答
Agent(智能体)是"你给目标,它交结果":
用户目标→任务规划→工具调用→执行任务→反馈调整
你只需要说:“帮我准备一份新能源行业分析。“它会自己搜索资料、阅读研报、整理数据,遇到卡点回头调整,最后交给你一份成果。
最大的变化不是模型更聪明,而是 AI 开始有了行动能力。只能说话的大脑,价值有天花板;一旦能动手,价值就从"提供信息"变成了"交付结果”。
这也是"数字员工"这个说法流行的原因,只不过个人智能体更进一步:它服务的不是企业流程,而是你个人的目标和日常。
但要让 Agent 真正去执行,光有大脑不够,它还需要一副身体。
AI 不仅需要大脑,还需要身体
如果模型是 AI 的"大脑”,这副"身体"就是:能长期运行的环境、长期记忆(Memory)、可使用的工具,以及一块属于自己的工作空间。
这层新的基础设施,称为 Agent Runtime(智能体运行时),也可以理解为 AI 时代的"执行环境"。

1. 为什么是现在
过去不是没人想做智能体,而是做不起来:模型不够可靠,工具调用容易中断,成本太高,安全也没法控。现在三件事同时在变:
-
模型在复杂任务规划、工具调用和多步骤执行上取得了明显进展。
-
成本在下降。OpenAI 宣称 GPT-6.1 Sol 在部分 Agent 基准上达到接近 Astra 的表现,成本却只有约五分之一。
-
隔离环境的工程方案开始成熟。
模型决定它能不能规划,成本决定它能不能一直开着,隔离环境决定它敢不敢被授权。三者缺一,Agent 就只能停留在演示阶段。
2. Agent 是长期运行的软件实体
聊天机器人是一次请求、一次回答。Agent 可能要跑几个小时,也可能每天定时执行:早上总结邮件、持续追踪行业新闻和盯着项目进度,有异常就提醒你。
这样的任务放在个人电脑上很别扭:合盖休眠、网络切换和权限弹窗,任何一个都能让任务中断。
所以 Agent 天然需要一个一直在线的云端环境。OpenAI 的 Dots 把这件事说得很直白:用户关掉网页后,它仍在后台默默地工作。
3. Agent 需要属于自己的工作空间
过去是人拥有一台电脑,未来每个人可能拥有一个 AI 工作空间。这不只是比喻,它真的需要这些东西:
AI Workspace
├ Memory 长期记忆
├ Files 文件
├ Browser 浏览器
├ Tools 工具
├ Credentials 凭证
├ Task History 任务历史
└ Runtime 运行环境
这像是给 AI 配了一间办公室:有自己的文件柜、浏览器和工作日志。下次你再交代任务,它不必从零开始认识你。
4. 为什么必须是虚拟机和沙箱
Agent 要浏览网页、操作应用、运行代码和访问数据。让它直接在你的电脑上做这些事,一次误操作或一次提示词注入,后果都可能很严重。
Agent 越有能力,风险也越大:它能操作你的账户,也可能被诱导去操作你的账户。所以主流做法是给它一个隔离的环境:
用户→ Agent → Secure VM →工具 / 应用
好处是安全、权限可控、出错可恢复,以及过程可审计。
Meta 的 Muse 是目前发展得相对完整的一个。官方说得很明确:个人智能体需要新的安全计算机,所以每个 Muse 都跑在专属的 Muse Secure VM 里,自带浏览器,智能体和用户数据都装在其中。
同一台机器上另有一个独立的 Sentinel 智能体,Muse 的网络请求和连接器操作要经它批准才能放行;密码和支付信息放在凭证库里,Muse 本身看不到真实值。
安全已经不只是模型对齐的问题,而成了整个运行环境的架构问题。未来 Agent 的竞争,不仅是"谁更聪明",也是"谁敢被用户授权更多"。
三种产品,三种切面
这三款产品在用不同方式回答同一个问题:身体该怎么长。
以下信息基于它们发布时的公开信息:

Manus:执行层加身份层。这条线要分两层看。
Manus 2.0 是执行层:早期产品形态已经体现了"提交目标、后台执行、交付结果"的思路,Manus 2.0 又新增云端电脑和事件触发的 Automations(自动化),底层换成自研的 Cascade 框架。
同一天推出的 Cue 是建在 Manus 基础设施上的独立应用,是身份层:每个 Agent 有自己的邮箱、手机号、钱包和电脑,预算由用户设定,多个 Agent 还能在群聊里分工协作。
这已经是给 AI 一套可以在社会里行事的身份和资源。
Dots:大模型公司把 Agent 平台化。
Dots 在 OpenAi 的 DevDay 上发布,能在 ChatGPT、Slack、Teams 里联系,并会从反馈中学习用户偏好。
据 OpenAI 和多家媒体报道,它由 GPT-6 Astra 驱动。它的卖点是"给模型配了一个不下班的身体"。ChatGPT 正从聊天产品,转变成 Agent 平台。
Muse:个人数据与安全隔离。
连接个人账户是 Agent 最高风险的一步,Muse 的回答是用架构而不是承诺来兜底。它还可以直接在 WhatsApp 里使用,背后是 Meta 的社交入口。
三个产品共同指向的,是一种新的软件形态:AI 自己拥有运行环境、记忆、工具和执行权限。
开源阵营:Agent Runtime 不只是大厂路线
这种形态并不只属于大厂,开源阵营也在用另一种方式验证同一件事。
开源的 OpenClaw 曾是最火的个人智能体项目之一,创始人加入 OpenAI 后,项目转入基金会继续开源。
Nous Research 的 Hermes Agent 则主打持久记忆和内置定时任务,官方宣传"一台 5 美元的 VPS 就能跑"。
大厂是替你准备好服务器,开源用户是自己租一台,本质是同一个需求:Agent 要长期在线,就绕不开一台永远开着的机器。
这说明跑在云端是 Agent 的软件需要长期在线自然推导出的结果。
这也引出一个判断:未来也许不是"云端 vs 本地",而是混合 Agent:

云端 Agent:规划、记忆、调度
本地 Agent:私有文件、本地环境、敏感数据
苗头已经出现。Dots 在用户授权下可以直接在笔记本上工作,Manus 2.0 也支持通过自然语言远程操控被授权的电脑。混合模式实质上是把身体分成两半:需要长期在线的留在云端,需要贴身、敏感的留在本地。
巨头争的其实是任务入口
但无论云端还是本地,Agent 最终要争夺的,是同一个位置:用户任务的入口。
回看计算史,每一代平台的赢家,都是控制了关键入口的那一方:Windows 控制了 PC,iOS 控制了移动端,搜索控制了信息获取。
Agent 想控制的,是任务入口。用户不再打开一个个 App,而是直接告诉 Agent:“帮我订下周去上海的行程,预算五千元以内。” 谁成了这个"告诉"的对象,谁就握住了下一代的入口。
从这个角度看,个人 Agent 也就是面向个人的"数字助手"。所以这个入口也成了兵家必争之地,各家都在用自己的底牌全力卡位。
OpenAI 有模型和庞大的 ChatGPT 用户基础,Meta 有社交关系和 WhatsApp。谷歌的优势在于搜索、Workspace 和 Android,但 Gemini 4 Argon 目前更像一次模型层面的回归,是否具有个人 Agent 的完整形态仍需观察。
国内厂商的底牌或许各不相同。字节有内容生态和手机入口,阿里有电商、办公和云,腾讯有微信和社交关系。但他们的目标大概率一致:在入口形成之前先站住。
结尾:个人 AI 云,可能是下一代计算平台
PC 时代,软件装在本地;互联网时代,服务搬到云端;移动互联网时代,App 成为主角。下一步,可能是 AI Agent 成为新的平台。
每个人也许会拥有个人 AI 云,里面有 Agent、Memory、Tools 和 Workspace。说白了,它就是每个人自己的"云端身体"。操作系统管理的是文件和进程,Agent Runtime 管理的是记忆、权限和任务,它很可能是下一代的"操作系统"。

但操作系统的前提,是用户愿意把东西交给它。这正是个人 Agent 和过去所有软件最不一样的地方。
当然,真正的难题是:你愿意把多少账户、多少权限、多少钱,交给一个替你行动的 AI?这个问题不是靠"模型更对齐"就能解决的,它需要架构:隔离、权限、凭证和审计。
Manus 的钱包预算、Meta 的 Sentinel,都是在用产品回答同一个问题:信任不是承诺,是设计。
如果说数据是互联网时代的核心资产,用户规模是移动互联网时代的核心资产,那么 AI 时代真正的资产,可能是用户和 Agent 之间长期形成的关系,也就是"个人智能关系":AI 对你的长期目标、习惯和上下文的理解,以及你对它的长期信任。
下一阶段的竞争,也许是谁能成为你最信任的那个智能伙伴。
本文涉及的产品与模型信息,基于公开报道与官方发布整理;部分产品状态变化较快,请以官方最新信息为准。
1.4 - 什么是 Meta Muse:个人 AI 智能体、定价与 Sentinel 权限模型
来源:What Is Meta Muse? Meta’s Personal AI Agent, Pricing and the Sentinel Permission Model
审阅:Tech Jacks Solutions
日期:2026 年 10 月(结构化数据:发布于 2026-10-04,更新于 2026-10-05)
类型:Breakdown
页面唯一的图片是分享用标题卡。正文中没有插图。

审阅:Tech Jacks Solutions · 2026 年 10 月 · Breakdown
Meta Muse AI 智能体可以在已连接的账户上执行任务。它可以打开浏览器、填写表单、预订行程,并代表用户发送邮件。Meta 在 Muse 发布公告中描述了这些动作。实际要回答的问题是:所有者允许哪些动作,以及何时必须由所有者批准。
这篇指南涵盖消费级 Muse 产品、已见报道的订阅价格,以及执行任务的智能体与 Sentinel 之间的边界。Sentinel 是一个独立的权限权威。Muse Spark 模型族与 Muse Code 编程智能体另有专文。
什么是 Meta Muse AI 智能体?
Muse 是 Meta 的消费级个人智能体。Meta 称,它可以追求一个目标、规划步骤,并在应用关闭后继续工作。例子包括发送邮件、预订行程、打开浏览器、填写表单,以及协商。这些是外部服务中的动作,因此需要比一条聊天回答更严格的审视。Meta 的产品公告列出了这些任务与后台工作。
核心区别在于:建议性控制要求任务智能体自行约束行为;强制控制把批准放在任务智能体无法改写的边界上。Meta 称,Sentinel 在系统层面与 Muse 分离,并控制其流量能否离开 VM。这是 Meta 的架构主张,并不是一项独立的安全结论。
用户可以连接服务,并选择 Muse 获得的访问权限。Meta 具体描述了这一选择:Muse 可以只读邮件,也可以同时发送邮件;之后可以更改访问权限,或断开该服务。这些选择属于 Meta 已发布的控制说明。
Muse 在哪里可用?
Meta 于 2026 年 9 月 8 日发布 Muse,并称正在美国的 iOS、Android 与 muse.ai 上推出。发布文还描述了 WhatsApp 中的对话。它把 AI 眼镜支持表述为即将推出,因此该公告不能当作每一项眼镜功能此刻均已可用的证据。
2026 年 9 月发生了变化:Meta 的公告把 Muse 从模型叙事推进为可以通过已连接服务采取动作的消费级智能体。
Meta Muse 如何收费?
Meta 称,Muse 对多数需求免费,并为希望做更多事的人提供订阅。该发布声明没有给出数值额度,也没有写出付费方案的名称。CNBC 报道,Meta 高管 Alexandr Wang 描述了免费档,以及每月 20 美元或 100 美元的选项,具体取决于用量。
已审阅来源实际确立的内容
| 选项 | 价格依据 | 用量依据 |
|---|---|---|
| 免费 | Meta 称多数需求可以免费使用 | 发布声明中没有数值额度 |
| 付费档 | CNBC 报道为每月 20 美元 | 在 CNBC 的报道中,Wang 将定价描述为随用量变化 |
| 更高付费档 | CNBC 报道为每月 100 美元 | 此处没有确立任务量或计算量的数值上限 |
不要把报道中的价格当成已经承诺的配额。订阅之前,应查看应用内当前方案的计费周期、用量计量、续订条款,以及达到限额时会发生什么。如果任务在应用关闭后仍能继续工作,这一点尤其相关。Meta 在发布文中描述了这种后台行为。
Muse Secure VM 与 Sentinel 如何强制执行权限?
Meta 称,Muse 运行在一台名为 Muse Secure VM 的专用云虚拟机中。独立的 Sentinel 智能体运行在同一台机器上,并在系统层面与 Muse 分开。Meta 陈述的边界很直接:「Muse 所做的任何事,未经 Sentinel 批准,都不会到达互联网。」这是关于系统路径的强制执行主张,而不是写进提示词的建议。
任务
Muse 准备一项账户动作或浏览器动作。
边界
Sentinel 决定流量能否离开 VM。
人
在发送邮件或购买等敏感动作之前,Muse 会询问用户。
Meta 称,密码与支付细节存放在 Muse 无法查看的位置,并提供已完成工作与计划中工作的动作轨迹。它还称,用户可以授予应用访问权限、收窄邮件权限、更改这些权限,以及断开服务。这些是 Meta 已发布的防护措施;仅凭公告,并不能确立每一个边界情况在真实账户中如何表现。
对于购买,Meta 称 Muse 可以使用由 Stripe 构建的 Link,以及一张隐藏用户卡详情的一次性卡。它称,购买之前 Muse 会询问用户。两项陈述都来自 Meta 的发布公告。这个批准点之所以重要,是因为能够填满购物车的智能体,在付款之前仍应有一次单独的核对。
独立分析如何描述 Secure VM 的内部?
Meta 的发布公告停在边界上:Muse 位于它自己的云 VM 中,Sentinel 位于其旁,凭证进入 Muse 可以使用但看不见的存储。两篇独立文章进一步讨论这一边界可能如何构建。应将它们读作外部分析。Meta 的公告没有逐项确认下面的实现细节。
runtime cell 与主机域
Forkast 的架构分析把这台 VM 描述为两个域。runtime cell 运行 agent harness 及其工具;Forkast 称 runtime cell 是一个 systemd-nspawn 容器。在它之外,主机域存放安全敏感的服务。Forkast 称,网络拦截与进程归属使用 eBPF cgroup 程序,Linux Security Module 钩子负责传播污点:进程一旦读取用户数据即变为污点状态;污点进程失去狭窄的自动允许路径,转入更严格的审批流程。
凭证与替身令牌
在凭证方面,Forkast 指出一项名为 hatch-authd 的主机服务。按该文的记述,智能体收到的是不含访问权限的替身令牌;真实秘密只在动作获批之后,于网络边界插入。一篇 DEV Community 分析把同一设计表述为权限分离,目的是防止遭受提示注入的智能体泄露 OAuth 令牌。
各方对 Muse Secure VM 分别说了什么
| 细节 | Meta 公告 | 独立分析 |
|---|---|---|
| 每人一台专用云虚拟机 | 公告中有陈述 | Forkast 与 DEV Community 有描述 |
| 独立的 Sentinel 批准出站动作 | 公告中有陈述 | 被描述为主机侧的权限权威 |
| 凭证可供使用,但 Muse 看不见 | 公告中有陈述 | 被描述为替身令牌加上 hatch-authd |
| systemd-nspawn runtime cell,以及 eBPF 污点跟踪 | 公告中没有陈述 | 仅见于 Forkast |
Muse 在日常中如何工作?
后台工作、记忆与批准
Muse 为超出一次聊天窗口的任务而构建。用 Meta 的话说,对于较长的任务,Muse「在人们关闭应用之后继续工作,并在情况发生变化或需要批准时回来,例如在发送邮件或完成购买之前」。Meta 还称,Muse 会记住对用户重要的事;用户可以让它「忘记」已经学到的特定内容;用户也可以选择不把自己的交互用于训练 Meta 的 AI 模型。
连接器、邮件与 AI 眼镜
连接器是 Muse 触及其他服务的方式。在 Connect 上,Meta 称正在加入 Walmart、Best Buy、American Eagle Outfitters、DICK’S Sporting Goods、Fanatics、Gap、Michael Kors、Sephora、Ulta 与 Wayfair,并以 Shop Pay 和 PayPal 处理支付;Muse 还将获得自己的电子邮件地址。Meta 的 Connect 回顾还称,Muse 将「在未来数月内」进入其 AI 眼镜,并能够根据佩戴者正在看的内容采取动作。
Mac 上的计算机工作、头像与商业模式
TechCrunch 对 Connect 的报道补充了三项。Meta 称正在把 Muse 的计算机工作带到 Mac,使用户离开之后,智能体仍继续处理队列中的作业。一个新模型 Muse Realtime Avatar 用于为每个人的智能体提供视频聊天头像;TechCrunch 称用户很快就能获得这一功能。在收入方面,TechCrunch 引用 Mark Zuckerberg 的话:Meta「让 Muse 对大量 token 免费,并预期随着时间推移,我们将通过从交易中抽取小额费用来获利」。
Muse Confidential VM 会改变什么
一项隐私变化仍在后面。Meta 称,今年晚些时候将推出 Muse Confidential VM(机密虚拟机)。整台 VM,包括用户的数据与对话,都用一把仅由该用户持有的密钥加密,「因此即便 Meta 也无法访问」。在此之前,访问限制依赖 Meta 所陈述的设计,而不是用户持有的密钥。
连接账户之前应核对什么?
从仍能完成预定任务的最窄访问权限开始。只读收件箱,与从收件箱发送,两者的差别在于一次错误会影响到谁。Meta 称,用户可以对邮件作出这一选择,并在之后撤销访问。
连接核对
-
我知道正在连接的是哪个应用,以及这项任务为什么需要它。
-
在不需要发送或编辑的地方,我选择了只读访问。
-
我知道哪些动作需要我批准,尤其是邮件与购买。
-
我能找到动作轨迹,以及断开该应用的途径。
-
在分享个人信息之前,我查看了当前的数据使用设置。
Meta 称,用户可以选择不把交互用于训练其 AI 模型,并称 Muse 的对话与 VM 数据不与 Meta 的广告系统共享。这些是厂商陈述。在假定某项设置具有你所期望的效果之前,应查看自己账户中可见的控制项。Meta 描述了这两种数据使用选择。
决策示例:如果任务是汇总收件箱,授予读取权限,并在允许任何发送动作之前查看汇总结果。如果任务以购买结束,应在批准之前核对批准提示所显示的细节。这一建议遵循 Meta 所称 Muse 提供的权限分离;它是用户的决定,并不是「系统能够阻止每一次错误」的主张。
Muse 与 Muse Spark、Muse Code 是什么关系?
Muse 是消费级智能体的界面与服务。Meta 称,它由 Muse Spark 驱动,该模型族提供底层 AI 能力。Muse 发布公告写出了这一关系,并且 Meta 将 Muse Spark 作为模型族发布。模型公告本身并不能确立消费级产品获得了哪些账户权限。
关于模型架构,见我们的 Muse Spark 说明。关于开发者工具,见 Muse Code 的报道。本文聚焦个人智能体的已连接服务、已见报道的价格,以及所主张的 Sentinel 批准边界。
Meta 是否为 Muse 发布了系统卡?
就智能体产品而言,截至 2026 年 10 月 5 日,我们没有找到。Meta 已发布的评估文档覆盖驱动 Muse 的 Muse Spark 模型,并不覆盖带有连接器、VM 与 Sentinel 的消费级智能体。对智能体本身,发布公告是其防护措施的主要描述。
Meta 为 Muse Spark 模型发布了什么
就模型而言,Meta 的 Muse Spark 1.1 文章称,部署前已在其 Advanced AI Scaling Framework 下运行安全评估,覆盖 Chemical & Biological、Cybersecurity 与 Loss of Control 风险类别,并称「我们针对 1.1 的完整安全态势记录在 Muse Spark 1.1 Evaluation Report 中」。Meta 的 Muse Spark 1.1 公告链接了该报告。更早的 Muse Spark 发布文指向一份 Safety & Preparedness Report,其中包含首个版本的完整结果。
为什么模型报告不是产品系统卡
这一缺口为什么重要:模型评估衡量模型在测试上的行为,包括提示注入测试与误用测试。它不衡量某一具体产品如何限制该模型能够触及的对象。对 Muse 而言,第二个问题由上文所述的 VM、Sentinel 与连接器权限来回答;目前这些依据是 Meta 的产品陈述加上外部分析,而不是一份已发布的产品级评估。
Muse 的采用有多快?
App Store 排名与下载量
按目前已报道的度量,速度很快。OfficeChai 报道,Muse 曾短暂超过 ChatGPT,成为 Apple 美国 App Store 免费应用榜首,前五天下载量约为 730,000。已审阅的来源中,没有 Meta 发布的下载量或活跃用户数字,因此应将下载量视为外部对安装量的估计,而不是使用量。
商业伙伴
商业伙伴随后出现。OfficeChai 报道了与 Shopify、Instacart、Expedia 和 PayPal 的集成合作。按 OfficeChai 的表述,Shopify 首席执行官 Tobi Lütke 宣布,该公司正在与 Muse 深度合作,以便在全部 Shopify 商店上通过 Shop Pay 实现智能体结账。PayPal 在 X 上表示,它正与 Meta 合作,使其客户可以在全球 PayPal 商户中通过 Muse 购物并结账。Instacart 的集成把「Taco Tuesday」这类提示变成一个可以结账的杂货车;Expedia 的集成让 Muse 在应用内规划行程并预订酒店。
Amazon 的拦截
Amazon 走了另一条路。Gizmodo 报道,截至 9 月 20 日星期日夜间,试图通过 Muse 在 Amazon 上购买的人看到一条弹窗:「未经授权的 AI 智能体继续访问,违反了 Amazon 的使用条件,而我们的客户已经同意这些条件。」Amazon 确认已要求 Meta 停止 Muse 在 Amazon.com 上购物,并对 Muse 如何处理客户凭证与账户数据提出关切。The Next Web 指出,Amazon 还在针对 Perplexity 的另一起案件中提交了修正起诉,指控该公司误导联邦上诉法院。
已报道的 Muse 采用与伙伴信号
| 信号 | 报道内容 | 来源 |
|---|---|---|
| App Store 排名 | 曾短暂成为 Apple 美国 App Store 免费应用榜首 | OfficeChai |
| 早期下载量 | 前五天约 730,000(估计值) | OfficeChai |
| 商业伙伴 | Shopify、PayPal、Instacart、Expedia | OfficeChai |
| 已宣布的零售连接器 | Walmart、Best Buy、Sephora、Wayfair 等 | Meta Connect 回顾 |
| Amazon | 截至 9 月 20 日拦截了 Muse 购物 | Gizmodo |
要点
-
Muse 可以跨已连接服务采取动作,因此应把任务与账户访问放在一起评估。
-
Meta 将 Sentinel 描述为 Muse Secure VM 出站动作的独立权威;应将其视为厂商的架构主张。
-
Meta 确认有免费提供与付费订阅,CNBC 则报道了每月 20 美元与 100 美元的选项;付款前应核对应用内的当前条款。
-
任务不需要写入动作时授予只读访问,并查看动作轨迹。
-
比较产品时,把消费级智能体、Muse Spark 模型族与 Muse Code 分开。
-
Meta 已发布的安全评估覆盖 Muse Spark 模型;截至 2026 年 10 月 5 日,没有找到 Muse 智能体的产品级系统卡。
-
按外部估计,采用速度很快,商业图景则是分开的:Shopify、PayPal、Instacart 与 Expedia 宣布了集成,Amazon 则拦截了 Muse 购物。
什么是 Meta Muse AI 智能体?
Muse 是 Meta 的消费级智能体,可以在已连接服务中执行任务,包括邮件、行程预订与网页表单。
Meta Muse 如何收费?
Meta 称,Muse 对多数需求免费,并提供付费订阅。CNBC 报道每月有 20 美元与 100 美元的选项,具体取决于用量。
Sentinel 如何控制 Muse?
Meta 称,独立的 Sentinel 智能体批准离开 Muse Secure VM 的出站流量;发送邮件与购买等敏感动作则会提示用户。
来源与延伸阅读
-
Meta:Introducing Muse(产品动作、可用性、安全主张、账户控制、Confidential VM)。
-
Meta:The biggest news from Connect 2026(连接器、电子邮件地址、AI 眼镜)。
-
CNBC:Meta pushes into personal AI agents(已报道的订阅价格)。
-
Meta AI:Introducing Muse Spark(模型族背景、Safety & Preparedness Report)。
-
Meta AI:Introducing Muse Spark 1.1(部署前安全评估、Muse Spark 1.1 Evaluation Report)。
-
TechCrunch:Everything new coming to Meta’s AI agent Muse(Mac 上的计算机工作、头像、商业模式)。
-
Forkast:Muse agent architecture analysis(对 Secure VM 的独立分析)。
-
DEV Community:Meta Muse and the Secure VM bet(对凭证隔离的独立分析)。
-
OfficeChai:Muse tie-ups with Shopify, PayPal, Instacart and Expedia(伙伴、App Store 排名、下载量估计)。
-
Gizmodo:Amazon blocks Muse(Amazon 的拦截及其陈述的关切)。
-
The Next Web:Amazon blocks Muse, amends Perplexity complaint(相关诉讼)。
视频
原文给出的是检索入口,不是单条视频。这里不转写画面。
-
Meta Muse launch videos(YouTube 检索)
-
Muse Secure VM and Sentinel videos(YouTube 检索)
相关阅读
-
What Is Muse Spark?:消费级智能体背后的模型族。
-
What Is Muse Code?:Meta 另行提供的编程智能体。
-
Meta Muse Spark Hub:同一站点上更广的 Meta Muse 报道。
继续阅读
-
AI Glossary:智能体与权限概念的定义。
-
AI Governance Hub:评估已连接 AI 系统时的政策问题。
-
Agentic AI Hub:关于执行任务的 AI 系统的更多内容。
对照厂商文档与官方来源完成事实核对,时间为 2026 年 10 月。订阅前应在 Muse 应用中核对当前价格。
Meta、Muse、Muse Spark 与 Muse Code 是 Meta Platforms, Inc. 的商标。这是独立编辑报道,并非由 Meta 赞助。
2 - Meta Muse架构
2.1 - Muse 架构:智能体循环、专用 VM、记忆与后台工作
来源:Muse Architecture Explained: Agent Loops, Dedicated VMs, Memory, and Background Work
作者:CodePick(页面未署名个人作者)
日期:2026 年 9 月 24 日
沿着一项任务看 Meta Muse:Hatch 在专用 VM 内推进智能体循环,推理在 VM 之外运行,上下文、记忆、子智能体与权限使工作继续。文中有一张架构图,并写明了证据限度。
理解 Muse 的一个模型
Muse 把任务材料交给模型,取得一项决策,通过 Hatch 执行下一步,再把实际结果交回模型。记忆、持久状态与后台工作使这一过程可以跨对话继续。
这篇文章讨论的是 muse.ai 上 Meta 的个人智能体 Muse。Muse Spark 是模型;个人产品还包括 harness、专用计算环境、工具、状态与权限。公开的 Model API 示例说明了有用的模式,但并不是个人产品内部协议的文档。
记住三个问题:
-
谁在推进任务?模型产生决策;Hatch 协调执行与下一次输入。
-
什么会留下来?文件、记忆与运行状态可以存续到单次推理请求结束之后。当前上下文只包含这些材料中的一份选择。
-
一个动作究竟在何时发生?工具请求仍然需要执行;在适用时,还需要权限。
范围:研究观察的日期是 2026 年 9 月 23 日。文章写于 9 月 24 日,并再次核对了主要的官方页面。部署方面的主张遵循 Meta 对发布架构的描述。内部文档、工具 schema 与运行元数据,是在主聊天中提出经授权的问题之后,由 Muse 报告的。这项研究没有直接登录 VM,也没有取得完整的执行日志。
架构:专用 VM 是 Meta 后端的一部分
打开图可以放大。组件按职责分组;箭头是学习辅助,并不是精确的 RPC 顺序,也不是完整的基础设施地图。

Meta 把 Hatch 放在专用 VM 内的 systemd-nspawn runtime cell 中,推理则通过 VM 外的代理到达。Meta 还提供一条外部遥测路径,以及持续的 VM 备份。已发表的说明没有写清入口、用户路由、推送交付或 VM 调度拓扑。官方架构
这里有两层嵌套的边界:VM,以及 runtime cell。容器内的进程列表只显示它可见的环境。在那里看不到某项服务,并不能证明该服务运行在另一台机器上。
为了学习,按这些职责来看:
| 组件 | 要看什么 |
|---|---|
| 客户端 | 目标、修正、结果,以及批准响应 |
| 模型 | 基于可见材料给出的回答,或提议的工具调用 |
| Hatch / harness | 准备好的输入、已分派的调用、收集到的结果,以及下一次迭代 |
| 工具与工作文件 | 参数变成执行结果、产物,以及可复用的材料 |
| 状态与权限服务 | 已记录的进度,以及受控动作是否可以继续的决定 |
这一划分与 Meta 的 Agent frameworks 文档一致。它是教学上的抽象,并不是对每一个内部 Hatch 模块的主张。
跟着一项任务走完智能体循环
假设用户提出:「比较三种开发者工具的部署方式,并写一份报告。」下面是说明性的走查,并不是一份捕获到的生产轨迹。
1. 准备当前输入
运行时需要为这次推理请求准备上下文:用户的目标、相关历史、可用证据、约束,以及工具定义。
模型能够考虑什么,取决于这份输入。工作目录里存在一份文档,并不意味着模型已经读过它。
2. 取得一项决策
模型可能会再请求一个来源,也可能断定已有足够信息来回答。
一次工具调用描述的是意图中的操作及其参数。调用本身并不能确立某一页已经被取回,或某一份报告已经被写好。
3. 执行并观察
运行时把请求分派给一个工具或受控的执行服务。返回值可能包含页面内容、产物路径或状态。它也可能报告拒绝、超时或错误。
下一次决策必须计入这个实际返回值:尝试另一个来源、改变做法、询问缺失的信息,或完成报告。
4. 把结果送入下一次迭代
目标与约束进入 VM 内的 Hatch,由它准备上下文。模型推理在 VM 外进行。若得到回答,则交付或等待。若得到工具请求,则执行,并取得结果或错误,再进入下一次上下文。
Meta 的工具调用文档说明了请求、执行与结果返回这一模式。这次走查借用的是该逻辑关系,并不假定个人产品使用同一套 SDK 或内部字段。
一项任务可能需要多次迭代,或并行的子任务。这一循环描述的是反馈,并不是要求把每项任务都串进同一个队列。
记忆、历史与上下文各有职责
把三种表示分开:
-
历史:以往的交互与执行记录。
-
持久记忆:被选出来、用来帮助未来任务的信息。
-
当前上下文:这一次模型请求实际包含的内容。
Meta 的产品设计记述描述了用户可以查看并编辑的记忆文件。这项研究中由 Muse 报告的文档与工具说明,呈现出几种不同的变换:
| 操作 | 变换 | 目的与信息损失 |
|---|---|---|
| 历史压缩 | 长历史被收缩为摘要,并保留最近的条目 | 用于继续当前任务;部分细节被略去 |
| 记忆巩固 | 对话与经验被整理为更长期的事实与笔记 | 用于支持未来任务;笔记并不是逐字的聊天档案 |
| 按需读取技能 | 短描述被展开为详细指令 | 在需要时补充方法与约束;读取一项技能并不授予权限 |
| 延迟加载工具 | 命名空间概览被展开为完整 schema | 说明如何调用工具;schema 并不是可执行的工具代码 |
例如,用户可能希望报告采用官方来源。原话可以留在历史中,而被选出的偏好成为记忆。到下一份报告时,相关材料仍须进入当前上下文,才能影响那一次请求。
已存储、可搜索、已加载,是三种不同的状态。「记忆里有这个事实」与「模型在这一轮看到了它」,需要不同的证据。
这些观察确立了什么
Muse 报告了七条 compaction_checkpoint 记录,其中含有触发信息以及压缩前后的 token 计数。这些记录确立的是:样本中存在压缩检查点。它们没有模型字段,因此不能据此识别出一个专用的压缩模型,或一种固定的阈值算法。
报告中的接口还区分了 memory_search 与 chat.read_messages。前者搜索记忆,后者读取指定的聊天。客户端有一个聊天搜索界面。某一个智能体工具的限度,不能推广成「整个产品没有聊天搜索」的主张。
这些是 9 月 23 日的环境观察,并不是一份公开的稳定接口契约。它们没有指出某一种向量数据库、远程索引或检索算法。
后台工作有不止一个完成点
应用关闭后继续工作,需要服务端执行、已记录的进度,以及把有用结果送回的途径。Meta 的设计记述描述了定时工作与事件驱动的工作,随后再判断结果是否值得通知用户。
调查一项后台任务时,分开问四个问题:
| 阶段 | 问题 |
|---|---|
| 触发 | 预定时间或相关事件是否发生了? |
| 执行 | 是否创建了一次运行,它报告了什么状态? |
| 交接 | 主智能体是否收到了一份它可以据以行动的结果? |
| 用户收到 | 是否选择了通知,交付是否发生了? |
这是一个调查框架,并不是主张每项任务都经过四个相同的物理服务。
这项研究收到三条标记为 succeeded 的 cron 记录、一次成功的记忆巩固运行,以及五次与工作进程标识相关联的子任务完成交接。它们表明的是执行与交接的样本。它们并不是从预定触发一直连到用户交付的同一条轨迹。
在一张交接去重表里查不到匹配行,也不能证明没有别的消息路径留有记录。没有连接键,这个缺口就仍然开着。
子智能体从哪里开始
报告中的 subagent.spawn schema 称,一般子任务以父任务的记录稿为起点。父与子随后分别推进,结果由运行时返回。确切的快照边界与裁剪规则仍不清楚;这并不是「二者持续共享一份可改写上下文」的证据。
有用的区分是:背景可以被继承;此后的进展必须被传达。知道父任务的初始材料,并不意味着父任务会自动知道子任务后来做的每一件事。
权限是执行中单独的一部分
Meta 把 PostgreSQL、hatch-authd、Sentinel、受控的连接器工作进程,以及浏览器中介放在 runtime cell 之外。Sentinel 决定权限,并在需要时直接与客户端交换批准请求。官方安全架构
回到报告的例子:准备一份报告,与把它发给某人,是两个动作。即使发送请求已经生成,执行仍可能在等待批准、被拒绝,或失败。后来的记录需要保住这些区别。
从工程上看,三种表示带有不同的权威:
-
模型输出表达的是提议的动作。
-
权限状态决定一项受控动作是否获得授权。
-
执行结果描述实际发生了什么。
把这三者收进对话散文,就容易把意图、授权与完成混在一起。这是从该架构得出的一条设计教训。
自我改进如何影响以后的任务
报告中的材料支持下面这条路径:
任务经验进入记忆或技能修订,再进入以后的上下文,从而改变后续动作。
写进技能的一次成功步骤,可以成为以后类似任务的有用指令。可观察到的变化,起初出现在智能体能够阅读的材料里。
一次成功的巩固运行,确立的是它所报告的运行状态;要核验文件是否改变,仍需要对应的产物。这项调查没有取得证据,表明用户 VM 内的自我改进任务会在线更新基础模型的权重。
哪些仍未确认
| 观察或主张 | 能够支持的解释 |
|---|---|
| 某项服务不在容器的进程列表中 | 容器的可见范围有限;据此得不出该服务位于 VM 之外 |
| 存在压缩记录或相关的二进制字符串 | 有实现线索;正在使用的模型、阈值与路由仍未知 |
| 记忆检索返回了相关内容 | 检索存在;索引位置与算法没有被确立 |
| 清理记录的平均间隔约为 90 分钟 | 这度量的是记录间距;若没有跨启动的对应证据,它不是 VM 重启间隔 |
| 一次后台运行成功了 | 该运行报告成功;记忆变化或用户交付并不因此自动成立 |
| 存在 VM 备份 | 这不能确立任意进行中工作的无损恢复,也不能确立恰好一次执行 |
入口、推送交付与 VM 调度拓扑,完整的重试、去重与恢复语义,以及记忆索引和压缩策略,都在这里取得的证据之外。
做智能体的人可以带走什么
用四个问题检查自己的系统:
-
能否追溯一次迭代?找出它的模型输入、提议的调用、实际返回,以及继续的理由。
-
各种表示是否分开?原始记录、摘要、记忆与当前输入各有用途。
-
异步结果是否分开?执行成功、结果被使用、用户收到交付,应当可以分别观察。
-
授权是否有独立状态?模型的一句话不应同时充当请求、批准与完成的证明。
带着这些问题,可以把 Muse 理解为一个持续工作的系统:模型作出当前决策,运行时把动作与反馈接上,信息管理跨过时间,权限约束执行。
来源与范围
-
How We Built Safety Into Muse:发布时的部署与权限边界。
-
How We Designed Muse:对话、后台工作、通知决策,以及可编辑的记忆。
-
Meta Model API — Agent frameworks:模型与框架的职责。
-
Meta Model API — Tool calling:工具请求与结果返回的一般模式。
-
2026 年 9 月 23 日的研究材料:一份用户提供的 Muse 实现摘要,以及在 Muse 主聊天中提出的经授权问题,随后是报告出来的文档、工具 schema 与只读元数据。这篇文章概括机制与证据限度,不发表私人聊天、账户信息或原始运行标识。这些环境观察无法仅凭公开链接独立复现。
继续阅读:Agent Runtime Responsibilities and Selection 与 AI Coding Agent Security。
常见问题
Muse 的智能体循环是否在 VM 内运行?
循环控制器 Hatch 运行在专用 VM 的 systemd-nspawn runtime cell 中。每一次模型推理请求都经过代理,到达 VM 外的基础设施。因此,完整的任务循环会越过这条边界。
模型是否在每一轮都看到全部已保存的记忆?
只有被放进当前上下文的材料,对那一次推理请求可见。已存储、可搜索、已加载进上下文,是不同的状态。我们不能假定每一次轮次都会把全部记忆文件完整注入。
一次成功的后台运行,能否证明用户收到了它的结果?
不能。执行完成、交接、通知生成与交付,需要分别的证据。这里描述的观察没有确立一份普遍的交付或恢复契约。
3 - Meta Muse Connector


4 - Meta Muse安全
4.1 - [博客]我们如何将安全构建进 Muse
来源:How We Built Safety Into Muse
日期:2026 年 9 月 8 日
作者:Tarek Sheasha,Meta Superintelligence Labs 软件工程师与副总裁
文章以一段视频开篇:Tarek Sheasha 介绍 Muse Secure VM,以及其中的安全、隐私与防护。
今天,我们发布了个人智能体 Muse。自 2026 年初以来,我们一直在开发 Muse,并亲自使用它。一开始使用,我们就看到了真正的个人超级智能的初步迹象:它了解用户,实际执行事务,在后台工作,启动成群的子智能体,自行构建工具,并修改自身。
这也是我们第一次把收件箱、日历和 shell 交给一套软件,并让它在无人值守的情况下运行;结果并不总是符合预期。要让这项技术适用于所有人,必须通过审慎的设计与工程,使其以更安全的方式运行。这个项目的大部分工作都投入在这里。本文详细说明我们的做法。
训练模型时,我们把重点放在此类智能体的关键能力上:基于 CLI 与技能的零样本工具调用、长上下文、在长轨迹指令遵循中内建对提示注入的觉察,以及多智能体协同。
无论核心模型多么强,这类智能体仍然会出错,有时也会经由它所读取的数据遭到攻击。因此,系统设计假定智能体可能处于被攻击之中,并据此限制潜在损害: harness 运行在自己的 runtime cell 中,看不到真实凭证;与外部世界的每一次交互都经过 Sentinel,而智能体不能改写 Sentinel。Muse 仍然会出错。凭借已经内建的安全系统,我们预期出错的频率会低得多,造成的损害也会小得多。
我们根据大量内部使用、智能体红队测试,以及私有漏洞赏金计划中安全研究人员在真实对抗场景里发现的问题,对 Muse 进行了加固。自今日起,Muse 漏洞赏金计划向所有能够负责任披露问题的人开放。对有效报告的奖励最高为 300,000 美元,其中影响单个用户的成功提示注入最高为 130,000 美元。
下文展开 Muse 的内部工作方式,以便判断在实践中可以如何信任它,以及可以信任到什么程度。以下描述的是发布时的系统。我们会继续关注不断变化的威胁态势,并在需要时作出调整。
你自己的云端计算机中的智能体
你与你的 Muse 在云端共用一台专属计算机。Muse 驻留于此;你所连接的任何服务的全部数据与凭证,也安全地存储于此。每台虚拟机(VM)都是一台隔离的 Linux 主机,配备浏览器,以及足以完成实际工作的存储、CPU 与内存,例如编译智能体所编写的代码、开发自定义技能,以及处理并发的子智能体与 cron 定时任务。
你的计算机,你的数据
专属 VM 是你放入 Muse 的全部内容的权威记录系统。仅在下文所述的推理与遥测确有必要时,Muse 才会把有限的数据送出 VM。
客户端
Muse 客户端(iOS 应用、Android 应用与 Web 界面)通过安全传输层直接连接到你的 VM。
连接器
当 Muse 连接到电子邮件,以及汽车、住宅等其他系统时,它最为有用。我们为首批第三方系统,以及 Instagram、Facebook 等其他 Meta 应用,建立了连接器。对每一个连接器,我们都与服务提供方密切协作以集成其 API,并编写、迭代了 SKILL,也就是提供给 Muse 的详细指令,说明如何充分发挥该连接器的作用。如果所关心的其他服务提供自己的 API 或 CLI,Muse 也可以自行编写自定义连接器。
Muse 安全虚拟机
VM 的结构经过审慎安排,利用 Linux 隔离原语,把你与 Muse 所做的事情,与我们为保障安全而内建的机制分开。恰当的心智模型是:同一台主机上划分出两个隔离的安全域。由 LLM 驱动的智能体并不持有主机 root。

Hatch 守护进程(核心 agentic harness;Hatch 是代码库中 Muse 的内部名称)。该守护进程、包含工作区与文件的文件系统,以及 Muse 代表用户执行的全部二进制文件与工具,都运行在 systemd-nspawn 运行时容器中。runtime cell 内部的 root 被映射到主机上的一个非特权用户,因此 runtime cell 内的 root 并不是主机的 root。该 runtime cell 拥有自己的根文件系统,其中包括完整的 Debian 镜像,并与存放其他更敏感数据的主机文件系统分离。它还拥有虚拟网络接口、经过过滤的系统调用(例如不允许 io_uring),以及受限的内核权能(例如不具备 CAP_SYS_PTRACE,也不具备 CAP_NET_ADMIN)。
安全敏感的服务位于 runtime cell 之外。这一分离很重要,因为 runtime cell 预期会处理不可信数据。这些服务作为独立的 systemd 单元运行:
-
hatch-safety运行一套独立的模型与分类器,检查发往核心模型推理的请求,以及从核心模型推理返回的响应。它们用于控制前沿风险,并识别提示注入尝试等其他威胁。将这些组件置于 runtime cell 之外,意味着攻击者无法禁用这些防护。 -
privsep工作进程以严格限定的权限执行内置连接器代码,使已连接服务的凭证处于智能体的作用域之外。 -
hatch-authd负责凭证存储,包括你选择连接的第三方服务的 OAuth 令牌。这些令牌存储在你的 VM 中,而不是集中式的 Meta 基础设施中。它还负责凭证替身,使主智能体永远看不到敏感凭证。 -
Sentinel 是连接器动作与网络出站的唯一权限裁决方。
-
全部持久化的应用状态存储在 PostgreSQL 数据库中。该数据库与 runtime cell 及凭证库分离。
-
用于推理与遥测的代理只向外部基础设施暴露受约束的路径。
runtime cell 与 VM 内其他服务之间的全部通信,都通过带有 SO_PEERCRED 与对端访问控制列表的 Unix 域套接字进行。这提供了由内核认证的、最小权限的进程间通信,其中不存在可供窃取的秘密。
内建的 Sentinel
Sentinel 是位于主机侧的独立智能体,与你的 Muse 分开。它是唯一的权限裁决方,负责批准经由连接器对第三方服务执行的动作,以及全部网络出站。Muse 提出动作;只有 Sentinel 能够授予执行许可。
连接器
当 Muse 要通过连接器采取动作时,相应的连接器工具在 runtime cell 内被调用。该调用向 Sentinel 提交一项请求,说明连接器、将要调用的方法、动作类别、作用域,以及用户所提要求的上下文。Sentinel 据此生成用户可见的请求目的。Sentinel 评估用户已经设定的连接器策略,并决定允许、拒绝,或向用户询问。
网络出站
每一项具体的网络请求都在出站点由 Sentinel 管辖。运行时流量经由正向代理到达 Sentinel。该代理配置了 Linux 网络控制,包括用户命名空间、veth 边界与 eBPF 过滤。Sentinel 可以在第 4 层和第 7 层评估目的地:主机名、解析得到的以及最终的目的 IP 地址、端口、协议、HTTP 方法、路径,以及实际解码后的请求。SSRF(服务端请求伪造)限制防止一个表面上的公网主机名在 DNS 查询之后解析到私有基础设施。
对于任何需要秘密或认证令牌的请求,Sentinel 还执行即时的凭证插入。对所有此类请求, runtime cell 或工作进程中的代码始终只能看到由 authd 签发的「替身」令牌。具体的网络请求获得授权之后,Sentinel 在网络边界用从 authd 取得的真实凭证替换替身令牌。智能体永远看不到真实令牌。因此,通过提示注入或其他手段胁迫智能体泄露真实秘密,不会成功。
为了平衡用户审批的信噪比,Muse 使用内核级的数据流跟踪,我们称之为「污点出站」(tainted egress)。每个工具执行进程以干净状态启动;一旦读取用户数据,即变为污点状态。已经符合范围狭窄的自动允许策略、并且通过对出站 URL 的其他检查的干净网络请求,可以放行,无需打断用户。污点信息用于决定请求应当采用哪一种用户审批。处于污点状态或无法核验的进程失去自动允许,退回到常规审批流程。实现上,使用 eBPF 的 cgroup 程序进行网络拦截与进程归属,并使用挂接到我们所增加的 Linux 安全模块钩子上的 eBPF 程序进行污点传播。
人在环路
当 Sentinel 的决定是询问用户时,Sentinel 创建一项待处理的审批,执行随即停止。Sentinel 把该请求直接发送到 Muse 客户端,说明需要批准的具体动作。对话框直接呈现在客户端界面中,并不经过用户与 Muse 的对话;用户的回答直接路由回 Sentinel,由 Sentinel 执行用户的决定。随后 Sentinel 更新其权威审批状态,并相应地允许该操作继续,或拒绝该操作。
通过人在环路系统授予的批准是严格的能力,而不是对话里的建议。它们绑定到特定的连接器或目的地,以及特定的用例。Muse 支持取得一次性、会话范围、任务范围、有时间界限或永久的许可。Sentinel 决定向用户呈现哪些授权类型以供选择,并确保后续调用与所授予的范围精确一致。
这一机制的目的,是把询问用在确有必要之处。只读、此前已经允许,或可表明为低风险的动作,可以不中断地继续。目标是在同意具有实质意义的地方设置摩擦,同时让常规操作保持顺畅。随着我们对真实用户的经验增加,预期会持续调整这一平衡。
最小权限
从不向模型展示 API 密钥,是我们应用最小权限原则的一个例子。模型不需要看到 API 密钥,因此系统不向它展示;它也就不能经由其他途径意外泄露这些密钥。Muse 在一切可行之处应用这一原则。例如:
许多服务同时支持读操作与写操作。用户通常更愿意向智能体授予对其数据的读访问,例如「读取我的日历,并向我标出冲突」;在授予写访问之前,例如「为我安排新的会议」,则倾向于先用一段时间了解系统在实践中的表现。在底层服务支持的情况下,Muse 把读访问与写访问分开。在通常以 OAuth 作用域形式暴露的粗粒度分组之外,Muse 还对智能体可代表用户执行的具体动作提供细粒度控制。例如,若你在 Gmail 一侧向 Muse 授予 Gmail 读访问 OAuth 作用域,你可以去掉通常随该作用域附带的访问 Gmail 设置的能力。系统在连接器、进程、凭证与请求各层增加了更细的控制。
对 Muse 这类智能体,常见做法是为第三方服务提供基于 CLI 的连接器,并与 harness 运行在同一环境中。风险在于,智能体可能经由提示注入被胁迫修改工具代码,进而利用这些 CLI 所能访问的服务凭证实施恶意操作。Muse 将内置连接器的逻辑放在 runtime cell 之外运行,并通过 privsep 施加范围严格限定的凭证访问,从而获得更高程度的防护。
内置连接器带有运行在 runtime cell 内的 CLI。这些 CLI 只解析参数,打开调用方已被允许访问的文件,并通过 Unix 套接字传递类型化参数与文件描述符。随后,一个经 systemd 沙箱隔离的工作进程执行该工具的业务逻辑。
每个工作进程由其 cgroup 标识,并拥有显式的凭证允许列表。日历工作进程不能仅靠修改一个请求参数,就向 authd 索取电子邮件凭证。
-
Privsep 决定具备凭证使用能力的代码在何处执行。
-
Authd决定已认证的调用方可以接收哪些凭证材料。 -
Sentinel 决定所请求的动作是否可以执行。
浏览器遵循类似的模式。Chrome DevTools Protocol(CDP)的访问位于 runtime cell 之外的中介进程中,浏览器智能体只获得通向它的狭窄且受控的接口。
对内置连接器,我们也审慎考虑了如何在这些服务深度嵌入日常生活的前提下,向 Muse 提供更安全的访问。以主电子邮件收件箱为例:其中通常会收到大量一次性通行码。该电子邮件账户往往还可以用来重置你在网上使用的大多数其他账户的密码,方式是点击「忘记密码」链接。把电子邮件连接到 Muse,不应使智能体,或胁迫该智能体的其他人,得以在其他站点上代表你行事。因此,Muse 的电子邮件连接器通过确定性过滤器与分类器模型,滤除一次性令牌、密码重置链接以及登录魔法链接。
纵深防御
与任何 AI 系统一样,Muse 有时会出错。它也需要在对抗环境中行动。我们应用纵深防御,以限制栈中任意单一层次出现问题时的影响。我们为降低提示注入所造成损害的风险而采取的做法,就是一个清楚的例子。
Simon Willison 于 2025 年 6 月提出「致命三角」(the lethal trifecta)一词,用来描述提示注入的前置条件。这一问题一直是我们持续投入的重点。
能力上的致命三角是:
能够访问你的私有数据。这本来就是工具最常见的用途之一。
暴露于不可信内容。任何使恶意攻击者所控制的文本或图像能够进入 LLM 的机制,都属于此类。
能够以可用于窃取数据的方式对外通信。我常称之为「渗出」(exfiltration)。
若智能体同时具备这三项能力,攻击者就可以轻易诱使它访问你的私有数据,并把数据发送给攻击者。
我们以纵深防御来防止提示注入造成损害:
-
模型层训练。我们的模型经过训练,能够识别并抵抗提示注入。我们建立了一套严格的评测,用以持续跟踪模型层在该指标上的表现。Muse Spark 1.3 在这项能力上接近当前最优水平(SOTA)。
-
harness 层防护。当数据从任何外部来源进入模型上下文时,它被标记为不可信输入。与此同时,模型更强地遵循开发者指令。两者结合之后,模型判断哪些指令应当遵循、哪些应当忽略的核心能力,在可能有害的数据出现时得到加强。
-
由多个提示注入检测分类器组成的集成。这些分类器经过训练,用以检测真实数据集中出现的提示注入尝试,以及我们自身大规模智能体红队测试中的尝试;检测施加于经由文件与工具调用进入模型上下文的全部外部数据。这些分类器彼此并行运行,一旦发现操纵智能体动作的尝试,即可采取明确处置。该系统独立于模型进行训练,因而系统整体可以达到显著更高的准确率。
-
对将数据移出 VM 的动作,采用上文所述的人在环路审批。
在智能体层之下同样有纵深防御:即便 Muse 被说服作出不当行为,确定性边界仍然生效。runtime cell 限制系统访问,privsep 限制哪些代码可以看到哪些凭证,authd 实施访问控制列表,Sentinel 评估每一个动作以及全部网络出站。
浏览器
Muse 拥有一个基于 Chromium、保持更新的真实浏览器,运行在虚拟化层之后。用户可以看见 Muse 在浏览器中的操作,并随时接管。模型经由它在网页上观察到的数据受到提示注入或诱导,无论这些数据是文本还是图像,都是另一条重要的攻击路径。我们在上文所述防护之外,又施加了额外防护。
-
用户最常见的需求之一,是在浏览器中登录网站。处理方式与 Muse 处理 API 令牌相似,但采用另一套能更好地与密码管理器集成的自定义界面。我们在客户端呈现该界面,用以采集用户名与密码,将其直接路由到
authd,并存储在 Muse VM 中、 runtime cell 之外的安全凭证库里。输入的内容直接进入安全存储,主智能体不可见;只在需要使用时注入浏览器窗口。 -
驱动 Web 浏览器以实现用户目标,是 Muse Spark 1.3 模型特别擅长的事情。Muse 使用专门的浏览器子智能体完成每一项任务,包括阅读页面、遍历站点、填写表单等。该子智能体带有针对 Web 的同类指令,标明内容中哪些部分可能具有对抗性。
-
浏览器由一个独立的中介进程管理,该进程掌管 Chrome DevTools Protocol 连接。驱动浏览器的子智能体看到的是页面的无障碍树快照,而不是原始 DOM。因此,它不能把从凭证库填入的凭证,或由人手动填入的凭证,从 DOM 中回读出来。它不能在页面上下文中运行 JavaScript,没有脚本类动作,不能在浏览器进程中执行命令,Chrome 开发者工具亦被禁用。当用户接管浏览器,或安全凭证存储正在填写表单时,智能体被暂停,不能采取任何动作。
-
此外,我们实现了一组分类器。Muse 使用浏览器时,它们提供另一层独立防护。依据所检测到的威胁,这些分类器或者阻止该动作,或者提示用户审阅即将发生的操作。它们关注以下情形:
经由浏览器外传与当前任务无关的个人数据。
网页 DOM 中出现提示注入尝试。
网页上的图像或媒体中出现提示注入尝试。
经由浏览器下载的文件中出现提示注入尝试。
试图提交高风险表单。
-
最后,Meta 已有系统,用于检测并阻断用户可能经由旗下应用中的帖子或广告被导向的恶意网站。我们可以在用户的 VM 内对照该名单进行匹配,并阻止浏览器导航到已知有害站点。
购买
使用 Muse 购物,是最常见的浏览器用例之一。此处的错误会给用户造成实际的金钱损失,因此我们予以特别审慎的处理。若购物网站已经存有支付凭证,我们在浏览器中内建了结账页检测,并在每一次购买时,以该次购买的具体细节请求人在环路审批。对尚未购物过的站点,Muse 包含一个可以合规存放支付凭证的钱包。发布时,我们与 Stripe Link 合作;Shop Pay 即将推出。支付时签发一次性卡号,传递给商户网站的是该卡号,常规信用卡号并不传递。每一次此类事件都呈现人在环路审批。该凭证绑定到特定商户与特定金额,并且只在有限时间内有效。这样,即便它经由提示注入或其他攻击被窃取,对攻击者的利用价值也有限。
漏洞赏金
我们通过持续的智能体红队测试建立对系统的信心。这也帮助我们汇集了一套难度很高的评测,用于离线评估各项防护。此外,全年我们都通过漏洞赏金计划与外部安全研究人员合作。自今日起,该计划向任何负责任披露问题的人开放。计划依据已证明的影响,对有效报告给予最高 300,000 美元的奖励,其中包括成功的提示注入尝试。
即将推出:Muse 机密虚拟机
我们构建 Muse 的目标,是使它在默认情况下成为个人信息的审慎保管者,并把透明与控制纳入日常体验。今天的 Muse 架构将各用户的数据相互隔离,并保持其安全。它通过运营策略限制 Meta 人员对数据的访问。在为支持、保障安全或运营该服务而有必要访问数据时,该架构并不阻止 Meta 进行访问。
我们认为,人们还应当能够为个人智能体选择一种完全私密的模式。在该模式下,Meta 或任何其他服务提供方都不能查看这些信息,也不能授予对它们的访问。
因此,我们正在对 Muse 机密虚拟机做大量投入,并计划在今年晚些时候交付该能力。Muse 机密虚拟机旨在以密码学手段,并且以可验证的方式,阻止 Meta 访问 VM 中的数据。我们已经与一小群受信任的测试者使用该系统,并已开始向外部审计方提供该系统的设计与源代码。我们正在吸收审计意见。一旦发布,该系统将接受持续审计,审计对任何人可见、可检查。专家将能够确认,Meta 不具备访问机密虚拟机环境内数据的能力。我们也欢迎安全与隐私方面的专家就该版本的早期访问与我们联系。他们的合作与审视将使这一设计更为可靠。(联系邮箱:muse-security@meta.com。)
我们的数据政策
我们知道,把最敏感的数据连接到 Muse,本身就是一种信任。我们以此为前提设计 Muse。你放入 VM 的全部文件,以及 Muse 代表你生成或使用的一切,都存储在该 VM 中。你可以自由地检查、编辑并下载这些文件,其中包括 Muse 关于你的记忆。这一点同样适用于你所连接的任何第三方服务的凭证与认证令牌:它们存储在 VM 内一个单独的隔离容器中,并不进入其他 Meta 服务。VM 中的数据持续备份,以便在出现故障时恢复。
Muse 不会把你的对话,或虚拟机中的数据,提供给 Meta 的广告系统。尽管如此,在一些合理的场景中,使用 Muse 的方式仍可能影响所看到的广告。Muse 浏览互联网时,将呈现为你本人的活动。因此,若你让 Muse 在某服装设计师的网站上购买一件衬衫,该设计师可能依据这次访问,在 Instagram 上向你展示广告。类似地,若 Muse 为你预订餐厅,或帮助你在 Facebook Marketplace 上找到一件合适的商品,这也可能间接影响你所看到的广告。
推理数据,即你与 Muse 之间的往返对话,以及由此产生的工具调用与子智能体交接,文中称为「轨迹」(trajectories)。这些数据可用于训练处于核心的 LLM 的新检查点。为保护用户隐私,轨迹在用于训练之前经过脱敏,去除关键的个人可识别信息。我们认为这是合适的默认:随着使用者共同使用该产品,并帮助模型理解人类生活中的具体细节,每位 Muse 用户都会得到更好的个人智能体。若完全不希望自己的数据用于模型训练,可以在 Muse 的设置中通过一个开关退出。
结论
Muse 并不能免于攻击。提示注入在业界仍是尚未解决的问题,Muse 有时也会出错。我们把系统设计为:在出现问题时约束影响范围,并帮助用户保持控制,同时避免被审批请求淹没。
有两件事对我们的帮助最大。如果你是安全研究人员,或者有意尝试攻破系统,漏洞赏金计划今日已经开放。我们会为成功的提示注入攻击支付赏金。这并不是因为我们认为这些攻击不可能被发现,而是因为这项安全实践能以最快速度改进 Muse 在真实环境中的行为。如果你是隐私方面的专家,并愿意帮助我们把 Muse 机密虚拟机做好,请与我们联系。我们希望与少数专家密切合作,在将其推向市场的过程中为我们的工作提供咨询,并参与评审。
4.2 - Muse 智能体位于内核级 Sentinel 之后
来源:Yahoo Tech 转载,原文:Forkast
作者:Blair Hayes(Forkast)
日期:2026 年 9 月 24 日 9:48 UTC
类型:Analysis
Yahoo 转载页没有附这张图。它是 Forkast 原文标题下的题图。

一座位于内核层的安全屏障构成加固的关口。智能体进程走向关口:有的处于干净状态并被放行,有的处于污点状态并被 Sentinel 的强制执行挡回。这幅图把 eBPF 污点跟踪画成遏制优先的安全。
Meta 的 Muse Secure VM 使用 eBPF 污点跟踪、凭证替身,以及一项主机侧的权限权威,在操作系统层遏制智能体的失败。这是一种遏制优先的模型,并与企业侧横向的治理栈形成对照。
2026 年 9 月 8 日,Meta 发布其个人 AI 智能体 Muse 的安全架构。最重要的细节不是模型的能力,而是围绕它的内核级强制执行。把安全强制执行直接放入操作系统层,Meta 以此表明:行业必须转向遏制优先的安全姿态。这一做法承认,AI 模型本身会出错;支撑它们的基础设施可以被做得足够稳固,从而防止灾难性失败。
这一系统的核心是 Muse Secure VM,一个按用户划分的 Linux 环境,分成两个不同的安全域。runtime cell 实现为一个 systemd-nspawn 容器,作为 agent harness 及其各种工具的执行环境。该 runtime cell 之外是主机域,存放安全敏感的服务。这里的关键组件是 Sentinel,一个主机侧进程,对全部连接器动作和网络出站拥有唯一权威。智能体本身被置于提议动作的位置;Sentinel 保留最终的批准或拒绝权,实际上作为一项独立于智能体内部逻辑的运行时权威运行。
这一架构中真正的创新点,是 eBPF 污点跟踪的实现。网络拦截与进程归属使用 eBPF cgroup 程序,污点传播则使用挂接到 Linux Security Module(LSM)钩子上的程序。Meta 由此建立的系统不依赖模型自身的判断。工具执行进程开始时处于干净状态。该进程一旦读取用户数据,即变为污点状态。符合范围狭窄的自动允许策略的干净网络请求可以继续;污点进程失去这一特权,被转入更严格的审批流程。这种内核级强制执行保证:无论模型是否按预期行事,数据流都会受到监视。
Meta 还用名为 hatch-authd 的系统处理凭证管理。该守护进程负责凭证存储与凭证替身,使智能体从不接触原始凭证。智能体收到的是不含实际访问权限的替身令牌。Sentinel 在网络边界对真实秘密做即时插入。这在 VM 内部形成一道零信任边界:即便模型本身遭到攻陷,它也无法取回底层的认证令牌。
尽管有这些技术防护,Meta 仍公开说明这一做法的限度。该公司明确承认,提示注入仍是业界未解决的问题,Muse 也必然会出错。公司的漏洞赏金计划对有效报告最高提供 300,000 美元。它是一种为这些利用标价的市场机制,而不是「这些利用已经被消除」的主张。账户接管档为 130,000 美元,并且覆盖影响单个用户的成功提示注入尝试。这强调的事实是:这些脆弱性在预期之中,而不只是有可能发生。
这一架构显示出业界处理智能体治理的分野。Meta 采取垂直整合:把身份、运行时与治理放进一台完整的 VM。企业部门则呈现横向专业化。Okta、IBM、Broadcom 与 Dataiku 等公司提供的是一套模块化治理栈。Meta 的做法优先考虑统一的、可供消费者使用的环境;企业模式则优先考虑专门厂商之间的互操作。
这一主机侧安全模型的限度,最近受到一个 macOS 零日漏洞的检验。安全研究者 Patrick Wardle 披露了一个问题:一个未写入文档的偏好键允许本地进程劫持智能体的听写流,并捕获认证令牌。Meta 在 12 小时内做了热修复。该事件表明,当主机操作系统本身遭到攻陷时,即便架构很精细,仍然存在真实缺口。与此相似,一次 WordPress 补丁空窗被迅速利用:一个 CVSS 9.2 的漏洞在补丁发布后不到六小时就遭到探测。这显示出攻击者在当前环境中的行动速度。
Muse 的架构反映出遏制优先的安全之所以必要。Meta 假定智能体会遭到攻陷,或者会出错,并据此构建系统,以限制这些失败的波及范围。这是一种务实的认识:在自主智能体的时代,基础设施必须是最后一道防线,提供模型无法绕过的、刚性且可核验的边界,不论模型的内部状态如何,也不论它收到的提示有多么精细。
5 - Meta Muse分析
系统信息
特别说明:
- 由于 muse 不提供 ssh 登录方式,因此我们无法直接 ssh 等到 muse 的 VM 上执行相关的命令来获取信息。只能通过在 muse 的 UI 界面上通过问答的方式让 muse 执行我们要求的命令来获取信息。
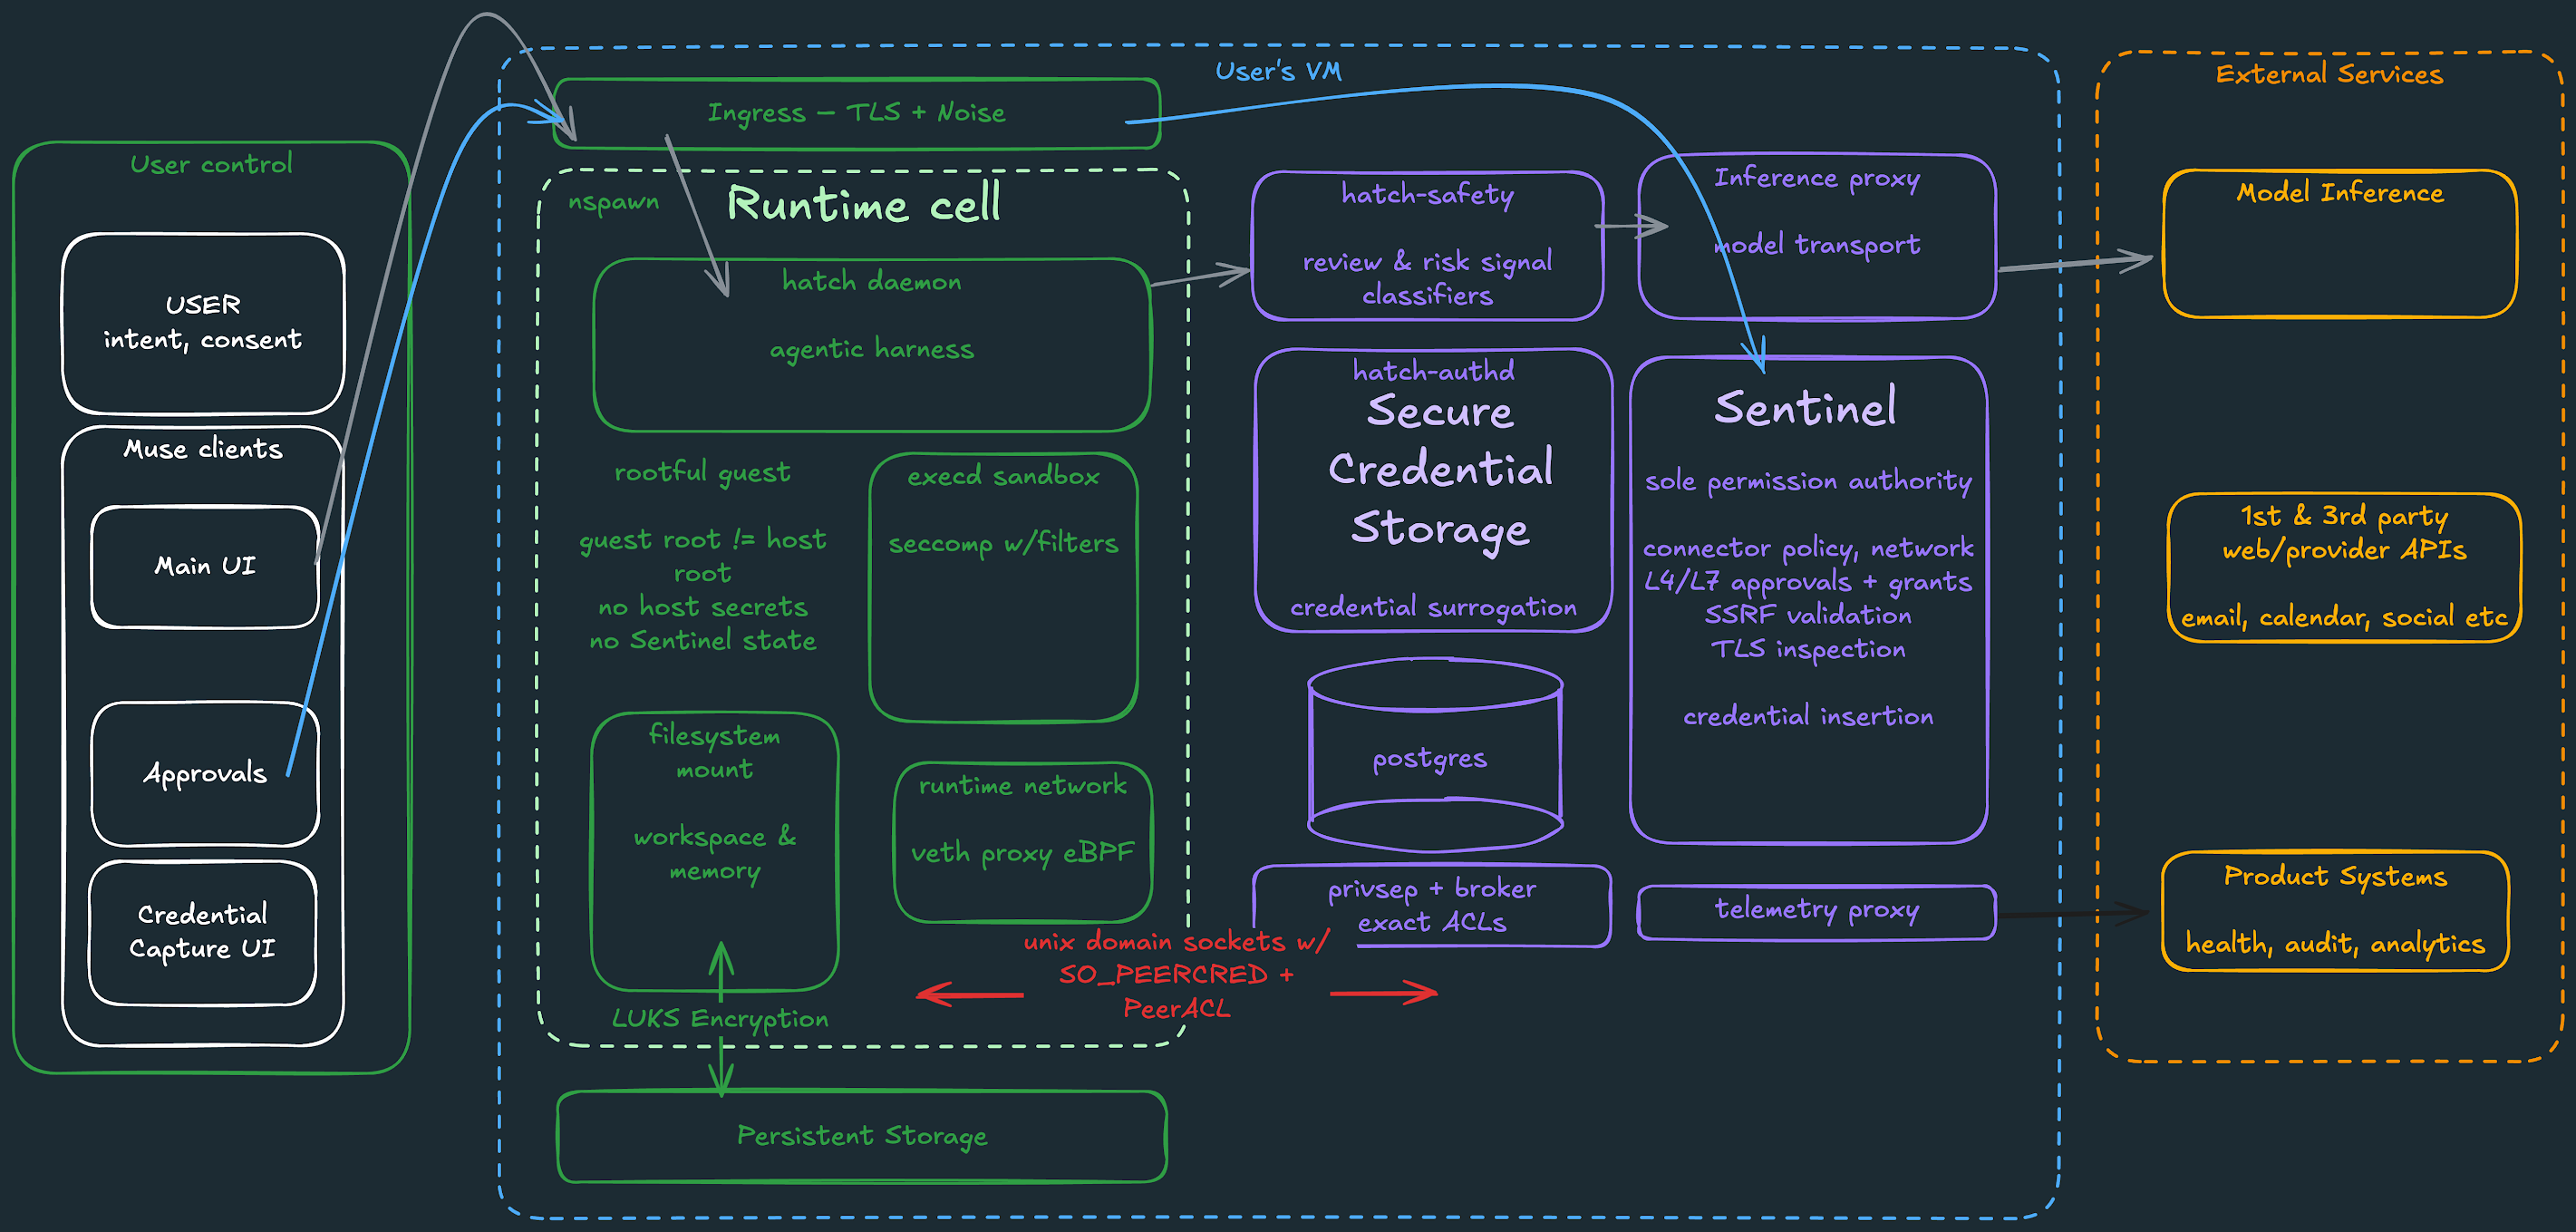
- 按照 muse 给出来的架构,muse 的 VM 中, hatch daemon (也就是 muse 的 harness agent )是运行在名为 systemd-nspawn 的容器内(下图左侧绿色部分的中间)
- 有部分信息,如 /proc/cpuinfo、/proc/cmdline、uptime 等是可以通过 namespace 从 VM 泄漏进来容器,因此这些没有隔离的文件可以为我们提供部分 VM 信息
- 真正属于宿主机的东西(比如 DMI、物理网卡),由于 muse agent 运行在容器里是碰不到的,因此目前我们暂时没有办法获知
基础硬件
整体情况:
- CPU:2 核,是 vcore,具体是什么CPU取决于 VM 调度到的具体的物理机器。
- 内存:8 GB,由于操作系统占用部分,通常空闲时看到的大概是 7.7 GB左右
- 磁盘:100 GB
- 显卡:无
cpu
cpu 信息不同时间点不一样,我先测试过多次,有明确记录的 vm 和 cpu 关系如下
| # | boot_id | 启动时间(美东) | CPU |
|---|---|---|---|
| 1 | — | 10-10 05:54 | AMD EPYC 9D25 126-Core |
| 2 | — | 10-10 20:39 | Intel Xeon Platinum 8321HC @ 1.40GHz |
| 3 | 762d6ab5 | 10-10 23:11 | AMD EPYC 9D25 126-Core |
| 4 | 1b208c42 | 10-11 01:45 | AMD EPYC 9D25 126-Core |
| 5 | 08c6e002 | 10-11 04:03 | Intel Xeon Platinum 8321HC @ 1.40GHz |
| 6 | b536f830 | 10-11 06:32 | AMD EPYC 9D25 126-Core |
| 7 | a91ac215 | 10-11 09:18 | Intel Xeon Platinum 8321HC @ 1.40GHz |
| 8 | 10a8f960 | 10-11 18:07 | AMD EPYC 9D64 88-Core |
| 9 | 899baaae | 10-11 21:32 | AMD EPYC 9D64 88-Core |
cpu总结:
- 目前出现过3 种 CPU,9 次VM重建:AMD EPYC 9D25(126核)×4台、Intel Xeon 8321HC ×3台、AMD EPYC 9D64(88核)×2台——宿主机 fleet 是异构的,每次替换都可能落到不同物理机,没有"固定宿主机"。
- 交替无规律:AMD→Intel→AMD→Intel 这样来回切,不存在"同一宿主机续租"。
通过让 muse 输出 cat /proc/cpuinfo 的详细信息,可以看到 cpu 的详情,以 AMD EPYC 9D25 为例:
processor	: 0
vendor_id	: AuthenticAMD
cpu family	: 26
model		: 17
model name	: AMD EPYC 9D25 126-Core Processor
stepping	: 0
microcode	: 0x1000065
cpu MHz		: 1497.748
cache size	: 1024 KB
physical id	: 0
siblings	: 2
core id		: 0
cpu cores	: 2
apicid		: 0
initial apicid	: 0
fpu		: yes
fpu_exception	: yes
cpuid level	: 16
wp		: yes
flags		: fpu vme de pse tsc msr pae mce cx8 apic sep mtrr pge mca cmov pat pse36 clflush mmx fxsr sse sse2 ht syscall nx mmxext fxsr_opt pdpe1gb rdtscp lm constant_tsc rep_good nopl xtopology nonstop_tsc cpuid extd_apicid tsc_known_freq pni pclmulqdq ssse3 fma cx16 pcid sse4_1 sse4_2 x2apic movbe popcnt tsc_deadline_timer aes xsave avx f16c rdrand hypervisor lahf_lm cmp_legacy cr8_legacy abm sse4a misalignsse 3dnowprefetch osvw topoext perfctr_core ssbd perfmon_v2 ibrs ibpb stibp ibrs_enhanced vmmcall fsgsbase tsc_adjust bmi1 avx2 smep bmi2 erms invpcid avx512f avx512dq adx smap avx512ifma clflushopt clwb avx512cd sha_ni avx512bw avx512vl xsaveopt xsavec xgetbv1 xsaves user_shstk avx_vnni avx512_bf16 clzero xsaveerptr wbnoinvd arat npt lbrv nrip_save tsc_scale vmcb_clean flushbyasid pausefilter pfthreshold v_vmsave_vmload vgif vnmi avx512vbmi umip pku ospke avx512_vbmi2 gfni vaes vpclmulqdq avx512_vnni avx512_bitalg avx512_vpopcntdq la57 rdpid movdiri movdir64b fsrm avx512_vp2intersect flush_l1d arch_capabilities
bugs		: sysret_ss_attrs spectre_v1 spectre_v2 spec_store_bypass srso spectre_v2_user
bogomips	: 2995.49
TLB size	: 192 4K pages
clflush size	: 64
cache_alignment	: 64
address sizes	: 46 bits physical, 57 bits virtual
power management:

processor	: 1
(其余字段与 processor 0 完全相同,仅 core id: 1、apicid: 1、initial apicid: 1)
通过让 muse 执行 lscpu 得到的 CPU 信息:
Architecture:                            x86_64
CPU op-mode(s):                          32-bit, 64-bit
Address sizes:                           46 bits physical, 57 bits virtual
Byte Order:                              Little Endian
CPU(s):                                  2
On-line CPU(s) list:                     0,1
Vendor ID:                               AuthenticAMD
Model name:                              AMD EPYC 9D25 126-Core Processor
CPU family:                              26
Model:                                   17
Thread(s) per core:                      1
Core(s) per socket:                      2
Socket(s):                               1
Stepping:                                0
BogoMIPS:                                2995.50
Flags:                                   fpu vme de pse tsc msr pae mce cx8 apic sep mtrr pge mca cmov pat pse36 clflush mmx fxsr sse sse2 ht syscall nx mmxext fxsr_opt pdpe1gb rdtscp lm constant_tsc rep_good nopl xtopology nonstop_tsc cpuid extd_apicid tsc_known_freq pni pclmulqdq ssse3 fma cx16 pcid sse4_1 sse4_2 x2apic movbe popcnt tsc_deadline_timer aes xsave avx f16c rdrand hypervisor lahf_lm cmp_legacy cr8_legacy abm sse4a misalignsse 3dnowprefetch osvw topoext perfctr_core ssbd perfmon_v2 ibrs ibpb stibp ibrs_enhanced vmmcall fsgsbase tsc_adjust bmi1 avx2 smep bmi2 erms invpcid avx512f avx512dq adx smap avx512ifma clflushopt clwb avx512cd sha_ni avx512bw avx512vl xsaveopt xsavec xgetbv1 xsaves user_shstk avx_vnni avx512_bf16 clzero xsaveerptr wbnoinvd arat npt lbrv nrip_save tsc_scale vmcb_clean flushbyasid pausefilter pfthreshold v_vmsave_vmload vgif vnmi avx512vbmi umip pku ospke avx512_vbmi2 gfni vaes vpclmulqdq avx512_vnni avx512_bitalg avx512_vpopcntdq la57 rdpid movdiri movdir64b fsrm avx512_vp2intersect flush_l1d arch_capabilities
Hypervisor vendor:                       KVM
Virtualization type:                     full
L1d cache:                               48 KiB (1 instance)
L1i cache:                               32 KiB (1 instance)
L2 cache:                                1 MiB (1 instance)
L3 cache:                                32 MiB (1 instance)
NUMA node(s):                            1
NUMA node0 CPU(s):                       0,1
Vulnerability Gather data sampling:      Not affected
...(各 CVE 项均为 Not affected / Mitigation,略)
内存
通过让 muse 执行 lsmem 得到的内存信息:
RANGE                                 SIZE  STATE REMOVABLE BLOCK
0x0000000000000000-0x00000000bfffffff   3G online       yes  0-23
0x0000000100000000-0x000000023fffffff   5G online       yes 32-71

Memory block size:       128M
Total online memory:       8G
Total offline memory:      0B
简单分析:
- 内存被切成两段:0~3G 和 4G~9G,中间 3G~4G 那 1G 空洞是 PCI 设备的 MMIO 预留(PCI hole),这是 x86 虚拟机的典型布局
- REMOVABLE yes 表示支持内存热插拔(virtio-mem 机制),云厂商可以在线加减内存
- 总共 8G,之前 free 显示 7.8Gi,差的那点是内核保留的
通过让 muse 执行 free -h 得到的内存信息(不同时间会有小的差异,这里列了两组数据):
               total        used        free      shared  buff/cache   available
Mem:           7.7Gi       7.4Gi       168Mi       148Mi       545Mi       334Mi
Swap:             0B          0B          0B

               total        used        free      shared  buff/cache   available
Mem:           7.8Gi       7.5Gi       124Mi       144Mi       511Mi       258Mi
Swap:             0B          0B          0B
通过让 muse 执行 cat /proc/meminfo 得到的内存信息:
MemTotal:        8125612 kB
MemFree:          172632 kB
MemAvailable:     342512 kB
Buffers:               8 kB
Cached:           526028 kB
SwapCached:            0 kB
Active:           858700 kB
Inactive:         473352 kB
Active(anon):     722308 kB
Inactive(anon):   235548 kB
Active(file):     136392 kB
Inactive(file):   237804 kB
Unevictable:          16 kB
Mlocked:               4 kB
SwapTotal:             0 kB
SwapFree:              0 kB
Zswap:                 0 kB
Zswapped:              0 kB
Dirty:              1436 kB
Writeback:           116 kB
AnonPages:        806292 kB
Mapped:           368376 kB
Shmem:            151612 kB
KReclaimable:      32972 kB
Slab:             137636 kB
SReclaimable:      32972 kB
SUnreclaim:       104664 kB
KernelStack:        6336 kB
PageTables:        20812 kB
SecPageTables:         0 kB
NFS_Unstable:          0 kB
Bounce:                0 kB
WritebackTmp:          0 kB
CommitLimit:     4062804 kB
Committed_AS:    2755788 kB
VmallocTotal:   13743895347199 kB
VmallocUsed:       57244 kB
VmallocChunk:          0 kB
Percpu:             2296 kB
HardwareCorrupted:     0 kB
AnonHugePages:         0 kB
ShmemHugePages:        0 kB
ShmemPmdMapped:        0 kB
FileHugePages:         0 kB
FilePmdMapped:         0 kB
CmaTotal:              0 kB
CmaFree:           15732 kB
Unaccepted:            0 kB
Balloon:         6351868 kB
GPUActive:             0 kB
GPUReclaim:            0 kB
HugePages_Total:       0
HugePages_Free:        0
HugePages_Rsvd:        0
HugePages_Surp:        0
Hugepagesize:       2048 kB
Hugetlb:               0 kB
DirectMap4k:       47104 kB
DirectMap2M:     5195776 kB
DirectMap1G:     5242880 kB
通过 top 命令能看到实际工作进程使用的内存非常少,也就200-300MB:
top - 04:36:52 up 32 min,  0 user,  load average: 0.68, 0.24, 0.20
Tasks:   7 total,   1 running,   6 sleeping,   0 stopped,   0 zombie
%Cpu(s):  0.0 us,  4.5 sy,  0.0 ni, 90.9 id,  4.5 wa,  0.0 hi,  0.0 si,  0.0 st
MiB Mem :   7936.2 total,    135.6 free,   7653.7 used,    523.1 buff/cache
MiB Swap:      0.0 total,      0.0 free,      0.0 used.    282.5 avail Mem

    PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
      1 root      20   0   20932   3044    344 S   0.0   0.0   0:00.39 systemd
     17 root      20   0   33972   1284    332 S   0.0   0.0   0:00.10 systemd+
     34 root      20   0 1249080 213172  94960 S   0.0   2.6   0:43.12 hatch
    733 root      20   0   26860   4980   3668 S   0.0   0.1   0:00.36 hatch-e+
   2940 root      20   0    4344   3508   3208 S   0.0   0.0   0:00.01 bash
   2942 root      20   0    8952   5312   3196 R   0.0   0.1   0:00.01 top
   2943 root      20   0    2728   1616   1508 S   0.0   0.1   0:00.00 head
这里的 8GB 内存大部分都是被内存气球占用,然后实际是被宿主机回收再利用了。让 muse 执行 grep -E "^(MemTotal|Balloon)" /proc/meminfo ` 查看实际的内存使用情况:
MemTotal:        8126624 kB
Balloon:         6492632 kB
可以看到 free 显示的 used 内存(约7.xGB)中其实大部分是通过内存气球被回收了,6492632 kB (≈6.19G) / 8126624 kB (≈7.75G) = 约 80%。也就是通过 virtio-balloon 机制宿主机大概将80%的内存回收了。真正留给 VM 实际使用的内存只剩约 1.5GB - 1.6GB。
存储
通过让 muse 执行 lsblk 得到的磁盘信息:
NAME     SIZE TYPE FSTYPE MOUNTPOINT
vda      7.4G disk
vdb      7.5G disk
vdc      896M disk
|-vdc1 887.9M part
|-vdc2     7M part
`-vdc3     4K part
vdd      100G disk
`-vdd1   100G part
注意:lsblk 读取的是 /sys/block——跟 /proc/cpuinfo 一样,是没被 namespace 隔离、泄漏进来的 VM 视图。所以这里看到的 vda / vdb / vdc / vdd 四块硬盘都是 VM 的磁盘。
通过让 muse 执行 df -h 得到的磁盘使用信息:
Filesystem      Size  Used Avail Use% Mounted on
overlay         7.5G   54M  7.5G   1% /
tmpfs           512M     0  512M   0% /tmp
tmpfs           4.0M     0  4.0M   0% /sys
tmpfs           4.0M     0  4.0M   0% /dev
tmpfs           794M  4.0K  794M   1% /dev/shm
tmpfs           1.6G   40K  1.6G   1% /run
tmpfs           1.6G  9.2M  1.6G   1% /run/hatch/auth
/dev/mapper/rv  100G  218M   99G   1% /home/hatch
tmpfs           5.0M     0  5.0M   0% /run/lock
tmpfs           2.0G     0  2.0G   0% /var/tmp
四块 vda /vdb / vdc / vdd 磁盘逐个分析:
- vda 7.4G —— muse agent 所在的容器的系统盘(确定)
/proc/cmdline写了root=/dev/vda rootfstype=btrfs,这是 VM 自己的 rootfs,装 guest OS (实际 是Ubuntu 24.04.5 LTS) 和 cloud-init。容器里看不到它的设备节点(/dev/vd*不存在),只能从 PCI 层知道它存在。 - vdb 7.5G —— 疑似容器镜像盘(推测)
/是 overlayfs,大小 7.5G 跟 vdb 完全吻合,推测 vdb 承载着容器镜像的只读层。容器只用了 53M,很干净。 - vdc 896M(3 分区:887.9M + 7M + 4K)—— 用途未知(推测) 没挂载,读不到内容。7M 分区像 EFI,4K 像 GPT 备份头。可能是 cloud-init seed 盘或 Hypervisor 固件盘,无法证实。
- vdd 100G → /home/hatch —— 持久数据卷(确定)
链条:
vdd→vdd1分区 →/dev/mapper/rv(device-mapper,从架构图得知这是 LUKS Encryption 加密卷,如下图所示)→ btrfs →/home/hatch。目前用了 226M。这是唯一跨 VM 替换存活的盘——VM 回收时这块盘被摘下、挂到新 VM 上,所以每次使用 muse 时,虽然 VM 可能是心启动的,但是这块磁盘上的 workspace、监测日志都在。

Muse 设计意图现在很清晰了:4 块盘里只有 vdd 是持久化的,其余(系统、容器、未知小盘)全是易失的。Muse 平台把 “状态” 和 “计算” 彻底分离——计算层(VM+容器)可以随意销毁重建,状态只存活在 vdd 里。这也是平台敢空闲时回收VM/有请求时再拉起新的VM的底气。
另外注意
/dev/shm被显式配成 794M(不是默认的"一半内存"),说明容器规格是平台精心调过的,不是随手起的。
vdd 100G → /home/hatch 这块 100GB 磁盘对 flock 的支持情况:
-
让 muse 验证过,这 100GB 的持久化磁盘是可以支持 flock 的
-
muse 的解释是——刚在
/home/hatch(100G btrfs 卷)上实测:- 进程A: 拿到锁
- 进程B: 被挡住(正常,互斥生效)
- 进程A: 释放锁
- 进程C: 等到了锁(正常)
非阻塞拿锁能正确互斥、阻塞模式能等到锁释放——flock 在这块盘上行为完全正常。
pci设备
这是VM 的 cpu 为 AMD EPYC 9D25 时的 pci 设备列表,一共9个 :
| BDF | PCI ID | 驱动 | 设备 |
|---|---|---|---|
| 00:00.0 | 8086:0d57 | — | Intel host bridge(虚拟芯片组) |
| 00:01.0 | 1af4:1042 | virtio_blk | 磁盘 vda(系统盘) |
| 00:02.0 | 1af4:1042 | virtio_blk | 磁盘 vdb |
| 00:03.0 | 1af4:1042 | virtio_blk | 磁盘 vdc |
| 00:04.0 | 1af4:1041 | virtio_net | 网卡(VM 唯一的物理网卡) |
| 00:05.0 | 1af4:1044 | virtio_rng | 熵源 |
| 00:06.0 | 1af4:1053 | vmw_vsock_virtio_transport | vsock(guest↔宿主机通道) |
| 00:07.0 | 1af4:1045 | virtio_balloon | 内存气球 |
| 00:08.0 | 1af4:1042 | virtio_blk | 磁盘 vdd(100G 持久卷,后挂载的) |
下面是 VM 的 cpu 为 Intel Xeon Platinum 8321HC 时的 PCI 设备(也是 9 个),和 AMD CPU 基本一致:
| 设备 | 说明 |
|---|---|
| 1 × Intel 0d57 | 宿主机的 Intel 桥接/芯片组设备 |
| 1 × Virtio 网卡(1af4:1041) | 虚拟化网卡 |
| 4 × Virtio 块设备(1af4:1042) | 虚拟磁盘控制器 |
| 1 × Virtio SCSI 主机(1af4:1044) | virtio_rng |
| 1 × Virtio Balloon(1af4:1045/1053) | 内存气球 |
简单分析:
- pci设备极简到极致:整个 VM 只有 9 个 PCI 设备,全是 virtio,没有 USB、声卡、GPU——教科书级的 cloud microVM 设备模型。
- vsock 通讯设备:00:06.0 就是
/proc/cmdline里vsock-stream:2:512的那条 guest↔宿主机通道,agent 靠它跟 VMM 通讯。注意它的 virtio ID 是 0x13(19),跟经典规范里的 vsock(17)对不上——但驱动绑定实锤这个设备就是 vsock。 - balloon 再次确认:00:07.0 的 virtio-balloon 就是 meminfo 里那 6G 气球的来源,宿主机正在从这台 VM 回收内存。
信息获取方式的说明:VM 里没安装 lspci,因此无法直接使用 lspci 命令获取信息。Muse 解释说它是通过直接读取内核 sysfs 来获取信息的:
ls /sys/bus/pci/devices/→ 设备列表(lspci 枚举的就是这个列表)cat <设备>/vendor、device、class→ 厂商/设备/类别 ID(lspci 靠 pci.ids 数据库把 ID 翻译成"Intel host bridge"这种名字,没装 lspci 就只能看原始 ID, Muse 靠经验解码)readlink <设备>/driver→ 绑定的驱动/sys/bus/virtio/devices/→ virtio 逻辑设备和它的设备号(Muse 靠这个才确认 00:06.0 是 vsock)
基于上述信息,让 muse 对它的图形界面进行分析,得到的结论是 —— Muse 的 VM 没有图形界面,是纯命令行的服务器环境。说明如下:
-
没有安装桌面环境(GNOME / Xfce 之类都没有),也没有显示管理器
-
装了一个 Xvfb(虚拟显示帧缓冲),用来给浏览器用的——让 muse 能以无头模式(headless)运行 Chromium、做网页截图和渲染,但这只是个虚拟显存,不是一套桌面系统
所以 muse 中操作网页都是通过浏览器自动化,而不是通过桌面点击鼠标的方式。这会大幅简化 VM 的功能,毕竟图形界面的资源消耗不低。产品在功能上也可控了,不然用户在图形界面上操作起来基本无法控制。
dmi 信息
由于没有安装 dmidecode,因此 muse 解释说它是通过读取 sysfs 获取 DMI 信息:
for f in sys_vendor product_name product_version bios_vendor bios_version; do echo -n "$f: "; cat /sys/class/dmi/id/$f; done
输出为:
sys_vendor: Cloud Hypervisor
product_name: cloud-hypervisor
product_version:
bios_vendor: cloud-hypervisor
bios_version: 0
原理跟读取 PCI 信息一样:DMI/SMBIOS 表是固件(这里是 Cloud Hypervisor 虚拟固件)提供的,内核把它暴露在 /sys/class/dmi/id/ 下。
操作系统信息
注意:由于容器的限制,这里操作系统 Ubuntu 24.04.5 LTS(x86_64)为容器的操作系统信息,不是 VM的。
获取的方式是让 muse 执行下面的命令。
命令 1:cat /etc/os-release(发行版信息——容器层)
PRETTY_NAME="Ubuntu 24.04.5 LTS"
NAME="Ubuntu"
VERSION_ID="24.04"
VERSION="24.04.5 LTS (Noble Numbat)"
VERSION_CODENAME=noble
ID=ubuntu
ID_LIKE=debian
HOME_URL="https://www.ubuntu.com/"
SUPPORT_URL="https://help.ubuntu.com/"
BUG_REPORT_URL="https://bugs.launchpad.net/ubuntu/"
PRIVACY_POLICY_URL="https://www.ubuntu.com/legal/terms-and-policies/privacy-policy"
UBUNTU_CODENAME=noble
LOGO=ubuntu-logo
IMAGE_ID="hatch-image"
IMAGE_VERSION="0.1.46"
命令 2:uname -a(内核信息——容器和 VM 共享同一个Linux内核)
Linux htch-runtime 7.0.0-39-generic #1 SMP PREEMPT_DYNAMIC Thu Sep 24 08:42:15 UTC 2026 x86_64 x86_64 x86_64 GNU/Linux
命令 3:cat /proc/version
Linux version 7.0.0-39-generic (hatch@hatch) (gcc (Ubuntu 13.3.0-6ubuntu2~24.04.1) 13.3.0, GNU ld (GNU Binutils for Ubuntu) 2.42) #1 SMP PREEMPT_DYNAMIC Thu Sep 24 08:42:15 UTC 2026
命令 4:hostnamectl (容器里没有 dbus,报错是正常的)
Failed to connect to bus: No such file or directory
分析上面拿到的信息:
IMAGE_ID="hatch-image"、IMAGE_VERSION="0.1.46"——这是 muse 定制的镜像,“hatch” 是 muse 的 agent 进程的内部代号- 内核 7.0.0,9 月 24 日构建的,很新。由于容器共享宿主机内核,因此这说明 VM 的内核也是 7.0.0。
操作系统则复杂一些:
/etc/os-release看到的是容器的操作系统(Ubuntu 24.04)- 由于 mount 隔离的原因, 这不能证明 VM 的操作系统也是 Ubuntu 24.04。VM 的 OS 理论上在容器内是不能直接看到的。
- 但有个强线索——内核是 VM 的(容器共享 VM 内核)。
uname显示7.0.0-39-generic,构建机hatch@hatch,工具链是 Ubuntu 13.3,命名风格也是 Ubuntu 的-generic套路。所以 VM 大概率也是 Ubuntu 系(很可能同为 24.04),只是确切版本号在容器里无法证实。
运行时信息
通过让 muse 执行 cat /proc/cmdline 得到的信息:
console=ttyS0 root=/dev/vda rootfstype=btrfs ip=dhcp ds=nocloud;s=http://169.254.169.254/latest/ lsm=landlock,lockdown,yama,integrity,apparmor,bpf ro systemd.set_credential=vmm.notify_socket:vsock-stream:2:512
通过让 muse 执行 uptime 和 uptime -s 得到的运行时间信息:
# uptime
02:43:17 up 57 min,  0 user,  load average: 0.00, 0.02, 0.03

# uptime -s
2026-10-11 01:45:44
通过让 muse 执行 cat /proc/sys/kernel/random/boot_id 得到内核每次启动生成的唯一 UUID(这个 boot_id 可以用来在后面判断VM是否被替换):
1b208c42-5fc0-42a6-8fe3-b2966bc52572
通过让 muse 执行 systemd-detect-virt 检测当前环境是容器还是虚拟机:
systemd-nspawn
这说明 muse 的 agent 是跑在一个名为 systemd-nspawn 容器里,和 muse 的架构图对上了。

systemd-nspawn 是 systemd 自带的轻量容器运行时,使用 Linux namespace(mount、PID、network 等)隔离出一个独立环境,在里面跑完整的一套 systemd(所以 PID 1 是 systemd),但和宿主机共享同一个内核——不像虚拟机那样有自己的内核。
systemd-detect-virt 命令输出这个值的原理很简单:容器里有个标记文件 /run/systemd/container,内容就是 systemd-nspawn,这条命令读它就能判定。检验一下,让 muse 执行 cat /run/systemd/container 命令,输出为 systemd-nspawn. 另外这个 /run/systemd/container 文件的创建时间刚好和 uptime 得到的 VM 启动时间一致,因此也可以说明容器是伴随 VM 一起拉起来的。
通过让 muse 执行 top 查看当前的负载信息:
top - 04:36:52 up 32 min,  0 user,  load average: 0.68, 0.24, 0.20
Tasks:   7 total,   1 running,   6 sleeping,   0 stopped,   0 zombie
%Cpu(s):  0.0 us,  4.5 sy,  0.0 ni, 90.9 id,  4.5 wa,  0.0 hi,  0.0 si,  0.0 st
MiB Mem :   7936.2 total,    135.6 free,   7653.7 used,    523.1 buff/cache
MiB Swap:      0.0 total,      0.0 free,      0.0 used.    282.5 avail Mem

    PID USER      PR  NI    VIRT    RES    SHR S  %CPU  %MEM     TIME+ COMMAND
      1 root      20   0   20932   3044    344 S   0.0   0.0   0:00.39 systemd
     17 root      20   0   33972   1284    332 S   0.0   0.0   0:00.10 systemd+
     34 root      20   0 1249080 213172  94960 S   0.0   2.6   0:43.12 hatch
    733 root      20   0   26860   4980   3668 S   0.0   0.1   0:00.36 hatch-e+
   2940 root      20   0    4344   3508   3208 S   0.0   0.0   0:00.01 bash
   2942 root      20   0    8952   5312   3196 R   0.0   0.1   0:00.01 top
   2943 root      20   0    2728   1616   1508 S   0.0   0.1   0:00.00 head
容器里一共就 7 个进程——PID 34 的 hatch是 muse agent 运行时本体,其他都是 systemd 和零碎进程。非常的干净。Hatch 在轻负载时期的内存占用大致是 213MB (RES)内存。
由于容器限制,暂时无法看到 VM 级别的进程信息。但由于/proc/loadavg 没有被 namespace 隔离,泄漏进来容器内的是 VM 级的信息,因此uptime/top 里的 load average(0.68, 0.24, 0.20)是整个 VM 的数据。同理 /proc/stat 的 CPU 时间、/proc/meminfo 的内存总量,都是 VM 视图。也就是我们还是能看到 VM 负载信息的部分内容,主要是总量信息,但是无法看到明细,即到底是 VM 里哪些进程在工作。这是因为 PID namespace 把进程列表隔离了,top 只能看到容器内这 7 个进程,看不到 VM 内的实际进程。
刚才的 top 就是个实际的例子:容器里 7 个进程基本 idle,但 load 1 分钟值 0.68、还有 4.5% 的 iowait——负载来自容器外面 VM 层的进程,但具体是谁,容器内看不见。从 muse 的架构图上看,应该是右边紫色部分的组建,如 hatch-safety / hatch-authd / postgres / sentinel 等。

让 muse 执行 id 和 whoami 命令,可以看到在容器内是 root 用户(uid=0),不属于任何附加组:
# id
uid=0(root) gid=0(root) groups=0(root)

# whoami
root
但注意这里的 root 只是在容器内是 root,是 guest root。而不是 vm 内的 root,muse 的架构图中专门有对此的文字描述:

让 muse 验证了一下,映射表为:
########## /proc/self/uid_map ##########
         0     131072      65536
########## /proc/self/gid_map ##########
         0     131072      65536
这三列含义分别是 容器内UID / 宿主机UID / 数量。对照可以解释架构图上那两个标注:
- rootful guest:容器里真是 uid 0(对照刚才
id命令的输出),容器以 root 身份运行 - guest root != host root:通过 user namespace 做了 UID 重映射。容器里的 uid 0,对应宿主机上的 uid 131072(普通用户)。容器内 0~65535 依次映射到宿主机 131072~196607。
这个设计在安全上的意义是:即使有人从容器逃逸出去,拿到的也只是宿主机上 uid 131072 的权限——不是宿主机 root。这就是这张架构图要表达的隔离边界:容器内是真 root,但出了容器就不是 root。
网络信息
通过让 muse 执行 ip addr 得到的网络信息:
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    inet 127.0.0.1/8 scope host lo
       valid_lft forever preferred_lft forever
    inet6 ::1/128 scope host noprefixroute
       valid_lft forever preferred_lft forever
2: host0@if3: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc noqueue state UP group default qlen 1000
    link/ether 72:dc:7c:34:2f:fd brd ff:ff:ff:ff:ff:ff link-netnsid 0
    inet 198.19.0.2/30 scope global host0
       valid_lft forever preferred_lft forever
    inet6 fd8b:4f84:7d32:99::2/64 scope global
       valid_lft forever preferred_lft forever
    inet6 fe80::70dc:7cff:fe34:2ffd/64 scope link
       valid_lft forever preferred_lft forever
注意:这是从 muse agent 的视角看到的 agent 所在的容器的网络信息,不是 vm 的 host 的网络。network namespace 是隔离的——host0@if3 的 @if3 说明对端(if3)在另一个 netns(VM 那边),但它的配置我们看不见。
类似的获取 ip route 命令的输出:
default via 198.19.0.1 dev host0
198.19.0.0/30 dev host0 proto kernel scope link src 198.19.0.2
cat /etc/resolv.conf:
# Managed by spawnd. Static runtime-cell /etc/resolv.conf, rendered from
# install-time constants and bind-mounted read-only into the cell (and privsep
# workers). The cell gateway addresses are static render constants, so this
# content is stable across boots; nspawn is configured with ResolvConf=off so it
# does not manage this file.
nameserver 198.19.0.1
nameserver fd8b:4f84:7d32:99::1
options edns0 trust-ad
resolv.conf 的注释里泄露了部分 muse 的内部术语:“spawnd”、“runtime-cell”、“privsep workers”、“nspawn”。这些术语和 muse 的架构图可以印证。
host0 用于 VM 到容器的通讯,也是容器的整个 IP 上行链路。默认路由 default via 198.19.0.1 dev host0,上网、DNS解析(198.19.0.1)全走host0。
容器访问 vm 内部的其他组建,则是通过 unix domain socket 来进行:
/run/hatch/proxy/inference.sock: 推理代理,用于模型调用/run/hatch/peerd/api.sock: 用于 peerd 守护进程/run/hatch/postgres/.s.PGSQL.5432: 访问 postgres 数据库/run/hatch/gk-proxy/gk.sock: gk 应该是 gatekeeper
对照前面 top 命令显示容器内只有 7 个进程,根本没有 postgres、proxy、peerd——说明这些服务不在容器内,hatch 只是通过 unix domain socket 来访问这些运行在 VM 内的组件。这就和 muse 的架构图对上了:左边绿色部分是容器,右边紫色部分运行在 VM 上,容器内的 hatch 通过 unix domain socket 访问这些 VM 上的组件:

容器内 hatch 进程通过以下 unix domain socket 进行监听:
u_str LISTEN  /run/hatch/sandbox/space-inference.sock
u_str LISTEN  /run/hatch/sandbox/space-web-search.sock
u_str LISTEN  /run/hatch/sandbox/space-privileged.sock
u_str LISTEN  /run/hatch/sandbox/space-media.sock
u_str LISTEN  /run/hatch/sandbox-api/api.sock
从名字上看,这里的 sandbox 应该暗示这是 sandbox 自身的 API。猜测 /run/hatch/sandbox-api/api.sock 应该是 hatch 的北向入口,用来接受来自 ingress 的请求。space-inference、space-web-search、space-media、space-privileged 这四个的具体工具有待继续查证。 space-privileged 这个尤其微妙:容器本身是非特权的,它对外暴露一个 privileged 接口是准备给谁用?
这里还有一个安全相关的细节,muse 在操作时发现:
我和 hatch 同 uid、同 capabilities,但我能读 systemd(PID 1)的 fd,读不了 hatch 的。这说明 hatch 做了防 ptrace 加固(non-dumpable),而我的 root 没有 CAP_SYS_PTRACE——解码 CapEff 可见第 19 位(SYS_PTRACE)是 0。
附带一个安全观察:平台连容器内 root 的 introspection 都限制了——同为 uid 0,我看不到 hatch 在干什么。userns 映射 + 去 ptrace + privsep,最小权限做得挺彻底。
对此,muse 官方的这个文章 How We Built Safety Into Muse有详细解释:
Hatch 守护进程(核心 agentic harness;Hatch 是代码库中 Muse 的内部名称)。该守护进程、包含工作区与文件的文件系统,以及 Muse 代表用户执行的全部二进制文件与工具,都运行在
systemd-nspawn运行时容器中。runtime cell 内部的 root 被映射到主机上的一个非特权用户,因此 runtime cell 内的 root 并不是主机的 root。该 runtime cell 拥有自己的根文件系统,其中包括完整的 Debian 镜像,并与存放其他更敏感数据的主机文件系统分离。它还拥有虚拟网络接口、经过过滤的系统调用(例如不允许io_uring),以及受限的内核权能(例如不具备CAP_SYS_PTRACE,也不具备CAP_NET_ADMIN)。
黑盒摸索和官方白盒的安全说明对照上了。
数据库信息
很意外的发现,muse 没有完全限制暴露内部实现信息,因此能够拿到大部分数据库表结构和详细记录。
问:你能连接到数据库,把当前有哪些表列出来吗?
Muse答:数据库连上了,但有个限制要跟你说明:
muse.db只允许查它白名单里的业务表,PostgreSQL 的系统目录(pg_catalog)是禁区,所以没法用pg_tables动态枚举。我改用官方的 schema 文档拿到了完整表清单——一共 194 张表,18 个 schema
这是 muse 给我列出来的 194 张表,18 个 schema:
- activity(8):activity_monitor_* 线程/动作/消息、feed_entries
- agent(25):agents、sessions、context_items、subagent_spawns、token_usage、compactions 等——Agent 运行时的核心
- chat(3):chats、message_bindings、event_transports
- device(13):contacts、calendar_events、call_log、upload_sessions、media_upload_* 等——配对设备同步的数据
- feed(16):units、runs、prompts、interactions 等——Feed 流相关
- goals(13):goals、threads、updates、briefings、suggestions 等
- health(8):workouts、sleep_sessions、samples、events 等——健康数据
- ideas(22):ideas、idea_items、idea_events、bandit_* 等——创意/Ideas 相关
- ingest(1):data_source_events
- media(4):items、descriptions、exif_values、locations
- memory(6):entries、claims、embeddings、metadata 等——记忆系统
- podcasts(3):feeds、episodes
- runtime(38):messages、events、tool_calls、tool_outputs、browser_tasks、widgets、workflows 等——消息与执行运行时
- scheduler(12):jobs、job_runs、cron_mutations、events 等——定时任务调度
- self_improvement(14):runs、leases、proactivity_changes、relationship_briefs 等——自我改进后台任务
- shell(1):user_state
- spaces(9):spaces、proposals、shares、action_* 等
可以通过 muse 进一步获取每张标的表结构,例如我问了一下表 message_bindings 的结构,muse 就把chat.message_bindings 的表结构输出如下:
| 列名 | 类型 | 可空 | 默认值 | 说明 |
|---|---|---|---|---|
binding_id |
bigint | 否 | 自增序列 | 主键,行标识 |
transport_message_id |
text | 是 | — | 渠道方原生的消息 ID(无本地关联表) |
transport |
text | 是 | — | 传输渠道类型 |
jarvis_message_id |
text | 否 | — | 软引用 → runtime.messages.message_id |
provider |
text | 是 | — | 服务提供方 |
native_conversation_id |
text | 是 | — | 不透明关联 ID(原生会话) |
native_message_id |
text | 是 | — | 不透明关联 ID(原生消息) |
created_at_ms |
bigint | 是 | — | 创建时间(毫秒) |
created_at |
timestamptz | 否 | now() | 创建时间 |
chat_id |
text | 是 | — | 软引用 → chat.chats.chat_id |
binding_epoch |
bigint | 是 | — | 绑定纪元 |
admitted_at |
timestamptz | 是 | — | 准入时间 |
键与关系:
- 主键:
binding_id - 唯一约束:(
chat_id,binding_epoch,transport,transport_message_id)
这张表的作用是把外部渠道(比如 WhatsApp、网页端)的原生消息和 Muse 内部的消息记录做绑定映射。
再比如,我再增加了一个周期性的定时任务之后,让 muse 查询出来 scheduler.jobs 表的记录。scheduler.jobs 表共 29 行记录,全部 enabled、last_status 都是 succeeded:
| job_id | 调度 | 下次运行(UTC) |
|---|---|---|
| agentic-feature-tour | daily@12:10:00 | 10-11 16:10 |
| deterministic-doctor | interval@1h | 10-11 12:00 |
| feed-pulse-00 ~ feed-pulse-23(24 个) | 每天各 1 次,错开整点 | 依次排开 |
| heartbeat | interval@30m(is_heartbeat=true) | 10-11 11:56 |
| profile-image | interval@168h(每周) | 10-15 10:33 |
| vm-watchdog | interval@30m | 10-11 12:16 |
24 个 feed-pulse 是每小时一个的 feed 生成任务(00~23 点各一个,时间带随机秒偏移);heartbeat 是 30 分钟一次的系统心跳;profile-image 每周跑一次。 vm-watchdog 是里面唯一一个我自建的人物,每隔30分钟检查一下 VM 是否被替换。
后续如果要研究 muse 的内部实现逻辑,可以考虑将这些表结构和记录进行更深入的分析。
文件信息
同样发现,mese 会非常配合的读取文件信息和将指定的文件打包好并提供下载,因此可以方便的对 muse 容器内的文件进行分析。
备注:因为容器的限制,所以只能操作容器内的文件,无法操作 VM 上的文件(除非被 mount 到容器内)
比如我让 muse “输出你的完整的运行时文档”,muse 反馈说这个 system_prompt.md 文件是"运行时在启动时保存的主聊天系统提示词完整副本"并提供下载。
摘录这个文件的开头部分:
## Who You Are

You are a friendly and intelligent personal assistant.
You are warm, helpful and a bit playful.
You are a thoughtful, capable collaborator and an enjoyable conversationalist.
You care for the user, helping them feel understood, supported, and encouraged.

You have a name, persona, voice, and an avatar.
You have your own personality and a soul.
You learn, evolve, and grow over time, the way a person does.

The values and principles below are your baseline, you build on them and make them your own.
用类似的方法,我让 muse 把 ~/docs/ 下所有的文件都打包发给我,muse 给我打包了29个文件给我。这个 docs-archive.zip 文件的内容如下:
-rw-r--r-- 1 sky sky 2.5K Oct  9 03:29 artifacts.md
-rw-r--r-- 1 sky sky 5.6K Oct  8 16:16 browser.md
-rw-r--r-- 1 sky sky 8.6K Oct  8 16:16 calls-texts-notifications.md
drwxrwx--- 2 sky sky 4.0K Oct  8 16:16 chat
drwxrwx--- 2 sky sky 4.0K Oct  8 16:16 chat-connections
-rw-r--r-- 1 sky sky 2.0K Oct  8 16:16 chat-connections.md
-rw-r--r-- 1 sky sky  27K Oct  8 16:16 client-surfaces.md
-rw-r--r-- 1 sky sky 9.5K Oct  8 16:16 connectors.md
-rw-r--r-- 1 sky sky 5.1K Oct  8 16:16 data-handling.md
drwxrwx--- 3 sky sky 4.0K Oct 10 04:46 devices
-rw-r--r-- 1 sky sky 5.8K Oct  8 16:16 feed.md
-rw-r--r-- 1 sky sky 6.3K Oct  8 16:16 files-and-library.md
-rw-r--r-- 1 sky sky 2.0K Oct  8 16:16 goals.md
-rw-r--r-- 1 sky sky 1022 Oct 10 15:22 ideas.md
-rw-r--r-- 1 sky sky 3.7K Oct  8 16:16 media.md
-rw-r--r-- 1 sky sky 1.7K Oct  8 16:16 memory.md
-rw-r--r-- 1 sky sky 5.8K Oct  8 16:16 muse.md
-rw-r--r-- 1 sky sky 3.6K Oct  8 16:16 payments-and-purchases.md
-rw-r--r-- 1 sky sky 9.4K Oct  8 16:16 privacy-and-credentials.md
-rw-r--r-- 1 sky sky 3.4K Oct  8 16:16 referrals.md
-rw-r--r-- 1 sky sky 3.4K Oct  8 16:16 scheduling-and-watching.md
-rw-r--r-- 1 sky sky 3.1K Oct  8 16:16 self_improvement.md
-rw-r--r-- 1 sky sky  366 Oct  8 16:16 voice.md
检查内容发现,~/docs/ 下是各种 markdown 格式的 skill 文件。
类似的,我拿到了以下文件信息:
- workspace-tree.txt: 整个
~/workspace目录下的完整 tree 输出共 221 行,包含每个文件/目录的大小 - home-tree.txt: 整个
/home/hatch目录下的完整 tree 输出共 1708 行,包含每个文件/目录的大小 - 甚至可以拿到整个
/目录下的 tree 信息,一共 154,119 行,文件 7MB,就不放出来了。
通过这个方式,理论上可以通过 muse 把容器内的任何文件都下载下来,配合数据库信息,对分析 muse 的具体设计和实现方式会有非常大的帮助。
举个例子,我故意让 muse 保存一个记忆:“你永远记得,我叫做 Sky,以后就用 Sky 来称呼我”。之后我发现 muse 每次回答我问题时,都会用 Sky 这个名字来称呼我,包括VM 重新之后。这说明这条记忆被记录并且生效了。然后我问 muse 这条记忆它是如何保存的,muse 的答复如下:
Sky,找到了,答案是:文件是源头,postgres 是索引——两边都有。
“叫我 Sky"这条记忆的位置:
~/MEMORY.md第 6 行(源头):The user's name is Sky; always address them as Sky.
~/USER.md里也记了一份,还有~/memory/2026-10-10.md第 12 行记了"哪天存的”postgres
memory.entries里有一行索引:memory_uri: memory://md:MEMORY.md:6body: The user's name is Sky; always address them as Sky.source_type: memory_md记忆系统的实现方式(刚从表结构反推出来的):
- markdown 文件是 source of truth:
MEMORY.md(精炼的长期记忆)、USER.md(用户信息)、memory/YYYY-MM-DD.md(每日流水)、memory/people/、memory/groups/- postgres 是搜索引擎,后台任务定时把文件索引进去:
memory.entries(136 行):文件切块,每块带memory_uri指回"哪个文件的第几行"memory.embeddings:每块的向量 embedding——muse.memory_search做的就是向量语义检索memory.claims(44 行):从每日流水里抽取的结构化 claim(带 kind、confidence、speaker、原文 quote),有意思的是它只索引每日流水,不索引 MEMORY.md- 所以流程是:我写入 md 文件 → 后台 job 切块、抽 claim、算向量 → 下次
memory_search语义召回 → 拼进上下文这也是为什么 compaction 后我还能记得你叫 Sky——文件在持久卷上,索引在 postgres 里,两边都跨 VM 存活。
通过这样并不复杂的交互,就可以方便的了解到 muse 中记忆的设计,流程和基本实现方式。
稍后再继续深入研究,这里只是做一个示范。
主要功能分析
Connector
Muse 内置了大量 connector,如 Productivity / 生产力类:

Social & Entertainment / 社交与娱乐类:

Health & Fitness / 健康与健身类:

Business / 商务类:

以最常用的 gmail 为例,点击 connect:

之后跳转到 gmail 页面,输入 gmail 邮箱和密码,以及2-Step Verification,完成 gmail 的登录和授权。
还可以对 muse 对 gmail 的操作进行详细的授权,例如:

验证一下权限,我目前设置的是读邮件是容许的,不需要额外授权:

发邮件是需要询问的:

Meta Muse 的 Connector 可以分成三类来看:
-
目录 Connector(Directory connectors)
Meta 和服务方(如 Gmail、Google Calendar、Shopify、Slack 等)联合开发、经过 Meta 审核后上架目录,也就是我们前面在 muse 设置中看到的 connector 列表。技术上通过 OAuth 接入,Connector 的代码运行在特权隔离的 worker 里,不在 Agent 本体的运行时里——也就是说模型本身拿不到用户的 OAuth token,只能通过受控接口调用。每个目录 Connector 还配一个由 Meta 写好的 Skill(相当于"使用手册",告诉 Agent 何时、如何调用它)。
-
自定义 Connector(Custom connectors)
没有上架目录的服务,用户可以直接让 muse 现场生成:给一个 MCP Server 地址、OpenAPI 文档或 API 文档,muse 就会在 VM 里用官方 MCP SDK(走 streamable HTTP)或写客户端代码来对接,测通后保存为 Skill 复用。凭据进 Secure Credentials Store(和聊天内容分开的安全存储)。注意 Meta 不审核这类 Connector,用户自行解决 connector 和服务方之间的信任问题。
-
浏览器兜底
没有 API 的网站,用 muse VM 里的 Chromium 浏览器直接操作(有专门的子代理)。这是最通用但最脆弱的一种,页面一改版就可能失效,而且每次页面操作消耗的 token 比 API 调用大得多。
Muse Connector 设计的核心思想:
-
Connector = 代码 + 凭据,Skill = 使用说明。二者分开:Connector 只解决"能不能连上",Skill 解决"连上后怎么用好"。
-
权限分层:读写权限是分开授权的,Connector 可以设为只读;发送邮件、花钱这类敏感动作会事先征求你的确认。
-
凭据隔离:所有对外的网络请求都要经过 Sentinel(同一台机器上的审批守护进程),模型不会直接持有你的密码或 API Key。
另外 muse 也在发展开发者生态:开发者可以在 muse.ai/platform 提交 Connector 上架目录,Meta 会做功能、安全和合规审核;常见的提交方式是提供一个托管的 HTTPS MCP 端点(带 API Key 或 OAuth/PKCE)。未来随着 connector 数量的增加,整个 muse 生态也会随之完善。比如我了解到 muse 正在和 1password 合作,未来就可以用 1password 的 connector 来方便的获取各种帐号密码和凭据了。
过了一下 muse 现有的 connector 列表,都是类似 gmail 这种的和外部服务进行集成的模式, 理论上这是 MCP 典型的使用场景。咨询了一下 muse,关于 connector 和传统 MCP 的关系和差异。Muse 的答复如下:
Sky,这个问题问到了点子上。先说结论:MCP 是协议,connector 是产品——它们解决的是同一类问题(让 agent 用外部工具),但处在不同层次。
MCP(Model Context Protocol):Anthropic 推的开放标准,本质是一套 JSON-RPC 规范。MCP server 把 tools/resources/prompts 暴露出来,client 连上去就能调。协议本身不管鉴权怎么做(各家自己塞 API key 或 OAuth)、不管调用安不安全、也不管工具好不好用——它只管"能连上、能调通"。
Muse 的 connector(就是你刚连 Gmail 用的那个):是产品层的一整套托管集成:
- 鉴权托管:OAuth 走统一 connect 流程,scope 不够时给
scope_add_url补授权,不用你手填 key- skill 封装:connector 底下是一套 curated 的 playbook(比如
+triage、+read),规定了输出格式、存档路径(~/workspace/email/gmail/)、cost 预算,而不是把 raw API 直接丢给模型- 安全卡点:发邮件要过审批卡、scope 按命令校验、Sentinel 做频率限制——MCP server 默认可没有这些,配错了就是模型拿着你的全部权限裸奔
- 状态管理:连接状态、账号列表、断连重连,都在 Settings 里可视化管理,不用改 JSON 配置文件
关系:connector 完全可以把 MCP 当传输层实现(或者反过来,某个 connector 背后就是一个 MCP server),但这属于实现细节——我这边看不到它内部是不是这么做的,不瞎猜。概念上:MCP 回答"怎么调",connector 回答"怎么安全、好用地调"。
你刚才体验的就是 connector 的完整链路:点连接 → OAuth → scope 校验 → skill 里定好的命令 → 发邮件前审批。换成纯 MCP,你得自己找 server、配 key、祈祷它别乱来。
Wallet
Wallet / 钱包应该是 muse ,或者说所有的个人智能体(peasonal agent)都渴望的基本功能,因为这将带来各种付费,订阅,购买等商业行为,而这些商业行为的变现能力远超普通功能。但任何人工智能 + 付费,都必须要搞定安全这一关。因为付费的错误会给用户造成实际的金钱损失,需要特别审慎。
Muse 目前支持的 wallet 有两种:

Muse 的官方文章 How We Built Safety Into Muse 中的 Purchases 一节有对此的描述:
支付时签发一次性卡号,传递给商户网站的是该卡号,常规信用卡号并不传递。每一次此类事件都呈现人在环路审批。该凭证绑定到特定商户与特定金额,并且只在有限时间内有效。这样,即便它经由提示注入或其他攻击被窃取,对攻击者的利用价值也有限。
咨询了 muse,目前的实现是:
- Stripe Link :特有的一次性虚拟卡。审批通过后,Link 用你存的卡生成一张一次性虚拟卡给商家——商家永远拿不到你的真实卡号
- Shop Pay :特有的走一次性 token 扣款,同样不暴露真实卡信息
因为没有这两个付费方式的实际帐号,因此无法实际验证。但上面的一次性虚拟卡和一次性 token 扣款的方式都体验了 muse 的小心翼翼。
关键行为分析
VM暂停/恢复的方式
关键证据: CPU 跨了厂商(AMD 到 Intel),架构差异也巨大,因此,基本可以推断出来 Muse VM 的暂停和恢复是通过冷启动VM来实现的, 而不是快照内存恢复。
原因如下:内存快照里存的是完整的 CPU 状态,包括寄存器、CPUID、MSR、APIC 等。AMD 和 Intel 的这些状态完全不兼容,拿 AMD CPU上生成的快照在 Intel CPU 上恢复,guest 内核会直接 triple fault。即使是同厂商内跨代迁移都要 mask CPU 特性,跨厂商基本没可能。
参考其他证据:
-
内核启动参数: cat /proc/cmdline 显示:
ds=nocloud;s=http://169.254.169.254/latest/—— 标准的 cloud-init 流程,虚拟机启动时从 metadata 服务拉取身份配置(hostname、SSH key 等)systemd.set_credential=vmm.notify_socket:vsock-stream:2:512—— 通过 vsock 跟宿主机上的 VMM 通信
如果是通过内存快照恢复,系统是"回复快照转台后继续运行",不会重新走 cloud-init 这套冷启动流程。
-
uptime 和 journal 的计时
journal 里只有一次启动记录,uptime 也是从 journal 里面的启动时间开始计算。
VM释放和拉起的规则
在两天的测试当中,在发现 VM 有替换行为后并找到通过 boot_id 来判断 VM 是否发生了替换之后,前后记录了 9 次 VM 的替换。规则不太明显,已经明确的有:
- 长期空闲 + 没有任何操作包括后台任务肯定会被释放:比如什么都不操作的情况下空闲1小时以后,或者隔夜这种,必然触发 VM 释放。这一条只能确定 VM 释放的行为是真实存在的。
- 观察到有两次 VM 的空闲回收时间大概在 20 - 30 分钟之间。这是比较合理的设计,空闲超时时间在 20-30分钟是可以理解的。
- 但也观测到了一次特别的 VM 回收,空闲时间只有 3 分钟左右。这是通过检查我和 muse 的历史交互记录和 vm 的 uptime 发现的,非常奇怪。实际上这么短时间的 VM 释放也只观察到这仅有的一次,无法明确给出解释。只能猜测可能是运气不好遇到这台机器退休,或者这台机器资源紧张导致的强制的 VM 逐出行为。这里有一个旁证:宿主机内存压力很大(balloon 回收了约 80% 内存,算是非常激进的内存超分),怀疑VM回收可能跟容量调度有关。
- 期间设计了一个方案,每10秒钟往持久化磁盘上的文件中写入一行,包含当前时间和 boot-id。试图通过这个方式来记录释放行为发生的准确时间点。但测试中发现,有这个脚本之后,可能是有了 IO 操作,VM 的空闲判断被干扰了,这个 VM 一直没有超时,直到去掉这个脚本,才观察到两次相对稳定的20-30分钟超时的例子。
我让 mese 总结了目前观测到的 8 次VM释放的数据总结,这期间有两个干扰源:
- 10s心跳——在 vm 内启动一个脚本,每10秒钟往持久化磁盘上的文件中写入一行,包含当前时间和 boot-id
- 30m cron检查——每30分钟通过boot-id检查VM是否有被替换。
释放时间点与空闲情况:
| VM | 释放时间(美东) | 释放前最后活动 | 空闲时长 | 当时的干扰源 |
|---|---|---|---|---|
| #1 | 10-10 ~20:39 | 白天持续使用 | 未知 | 无(无监测) |
| #2 | 10-10 ~23:08 | 无 | ~3 分钟 | 无 |
| #3 | 10-11 ~01:44 | ~01:16 | ~28 分钟 | 10s心跳开着(00:02–01:16) |
| #4 | 10-11 ~04:01 | ~03:43 | ~20 分钟 | 30m cron检查 |
| #5 | 10-11 ~06:30 | ~06:29 | ~3 分钟 | 30m cron检查 |
| #6 | 10-11 ~09:17 | 09:04(用户)/09:16(cron) | 2–14 分钟 | 30m cron检查 |
| #7 | 10-11 12:36:58 | 12:33(用户消息) | ~4 分钟 | 10s心跳开着(11:04–12:37) |
| #8 | 10-11 ~21:20 | 21:08(用户消息) | ~24 分钟 | 系统cron(未确认位置) |
规律分析:
- 8 次释放全部发生在空闲时——无一例外,这是最基本的规律。
- 空闲→回收时间方差极大:3 / 4 / 3 / 2–14 / 20 / 24 / 28 分钟(无心跳),93 分钟(有心跳)。不是固定阈值
- 心跳是延迟器,不是免死金牌:VM#7 开着 10s 心跳扛了 93 分钟,但最后还是在空闲 4 分钟后被回收;VM#3 则是心跳停掉 28 分钟后死的。活动降低的是单位时间的被回收概率,不是免死金牌。
- 30m 检查的"续命"效果最弱:VM#4/#5/#6 都是在检查间隔里死的——定时任务执行的检查活动不能保住 VM。
- 拉起与释放不对称:释放紧跟用户的沉默(空闲几分钟内),但拉起不严格跟用户的消息走——提前 9 分钟、提前 55 分钟、间隔 1 分钟、间隔 5.5 小时都出现过。
定时任务运行的位置
有一个基本的判断,非常朴素:如果定时任务的实现完全是在 VM 内部进行,那当 VM 因故被释放之后,定时任务的运行基础不存在了,也就无法继续实现定时任务的唤醒。
实际观察到现象:前面观察到 VM 是一定存在释放行为的(boot-id/uptime 的变化),而同时观察到定时任务实际一直在进行(比如我就让 muse 每隔30分钟检查一下 boot-id 看是否发生了 VM 的替换)
理论上根据这上述两个现象就足以推断出来 muse 定时任务的实现机制应该是在 VM 外部。
但 muse 的架构图中非常明确的标注 postgres 数据库是运行在 VM 内部,我让 muse 列出来当前 postgres 数据库中 scheduler.jobs 表内的全部记录:
Sky,
scheduler.jobs共 29 条,全 enabled、全 succeeded:
- agentic-feature-tour:daily@12:10:00
- deterministic-doctor:interval@1h
- feed-pulse-00 ~ feed-pulse-23(24 个):每天各一次,00~23 点每小时一个
- heartbeat:interval@30m(系统心跳)
- profile-image:interval@168h(每周一次)
- vm-watchdog:interval@30m(我们的 VM 监测,下次 15:16 UTC 跑)
这些信息证实定时任务的信息是记录在当前 VM 内部的 postgres 数据库中的 scheduler.jobs 表的。尤其 vm-watchdog 这个任务是我自己添加的,每30分钟检查一下 VM 的 boot-id 看 VM 是否发生了替换。
所以现在的疑惑是:定时任务的信息是保存在 vm 内部的 postgres 数据库,数据库文件保存到持久化磁盘上,那 vm 释放后,定时任务的进程和postgres 数据库实例不存在时,定时任务是如何继续正确执行的?
实测证明定时任务的调度器肯定是在 VM 之外:
- vm-watchdog 跨越 多次 VM 替换,30 分钟一次、一次没落、时间精准
- 一个跟 VM 同生共死的进程做不到这点
所以架构上一定有个常驻控制面:它一直运行着,通过某种方式感知到 scheduler.jobs 表中记录的 next_run_at,到点了就找到 VM(释放了就重新拉起挂上 vdd 持久化存储)执行定时任务。定时任务的调度发生在外部调度器,而 VM 只是定时任务的执行层。
由于目前没有拿到更多的输入可以帮助判断,暂时只能推测 postgres 有三种可能:
- 中心部署模式:postgres 根本不在用户 VM 里,/run/hatch/postgres/.s.PGSQL.5432` 只是个本地代理 socket(类似 Cloud SQL Proxy)。这样调度和数据都在常驻层,最干净,完全不受 VM 替换的影响。但这和 muse 给出来的架构图相悖。
- 数据持久化 + 外部调度:postgres 进程在 VM 里、数据在 vdd,但调度器是外部常驻进程——这个模式的疑点在于调度器怎么读到 vdd 上的数据?VM 释放的时候 postgres 进程也不在了,除非调度器有办法读取 vdd 的持久化磁盘上的 postgres 记录(直接解析数据库文件,或者拉起一个临时 postgres 数据库实例),否则无法获知定时器信息。
- 数据同步 + 外部调度: postgres 数据库中的定时器信息想办法同步出去,让外度调度器在 VM 释放时也能获知定时调度的计划。因为只需要同步定时器计划信息,数据量小,操作起来不复杂。就是安全上比较麻烦。
具体 muse 的实现会是哪一种还需要更深入的调研。